从展厅到数字化文物库
项目简介
参观博物馆时,观众往往只能隔着展柜从固定角度观看文物;普通的线上展览虽然突破了地点限制,却大多仍以图片和文字为主。
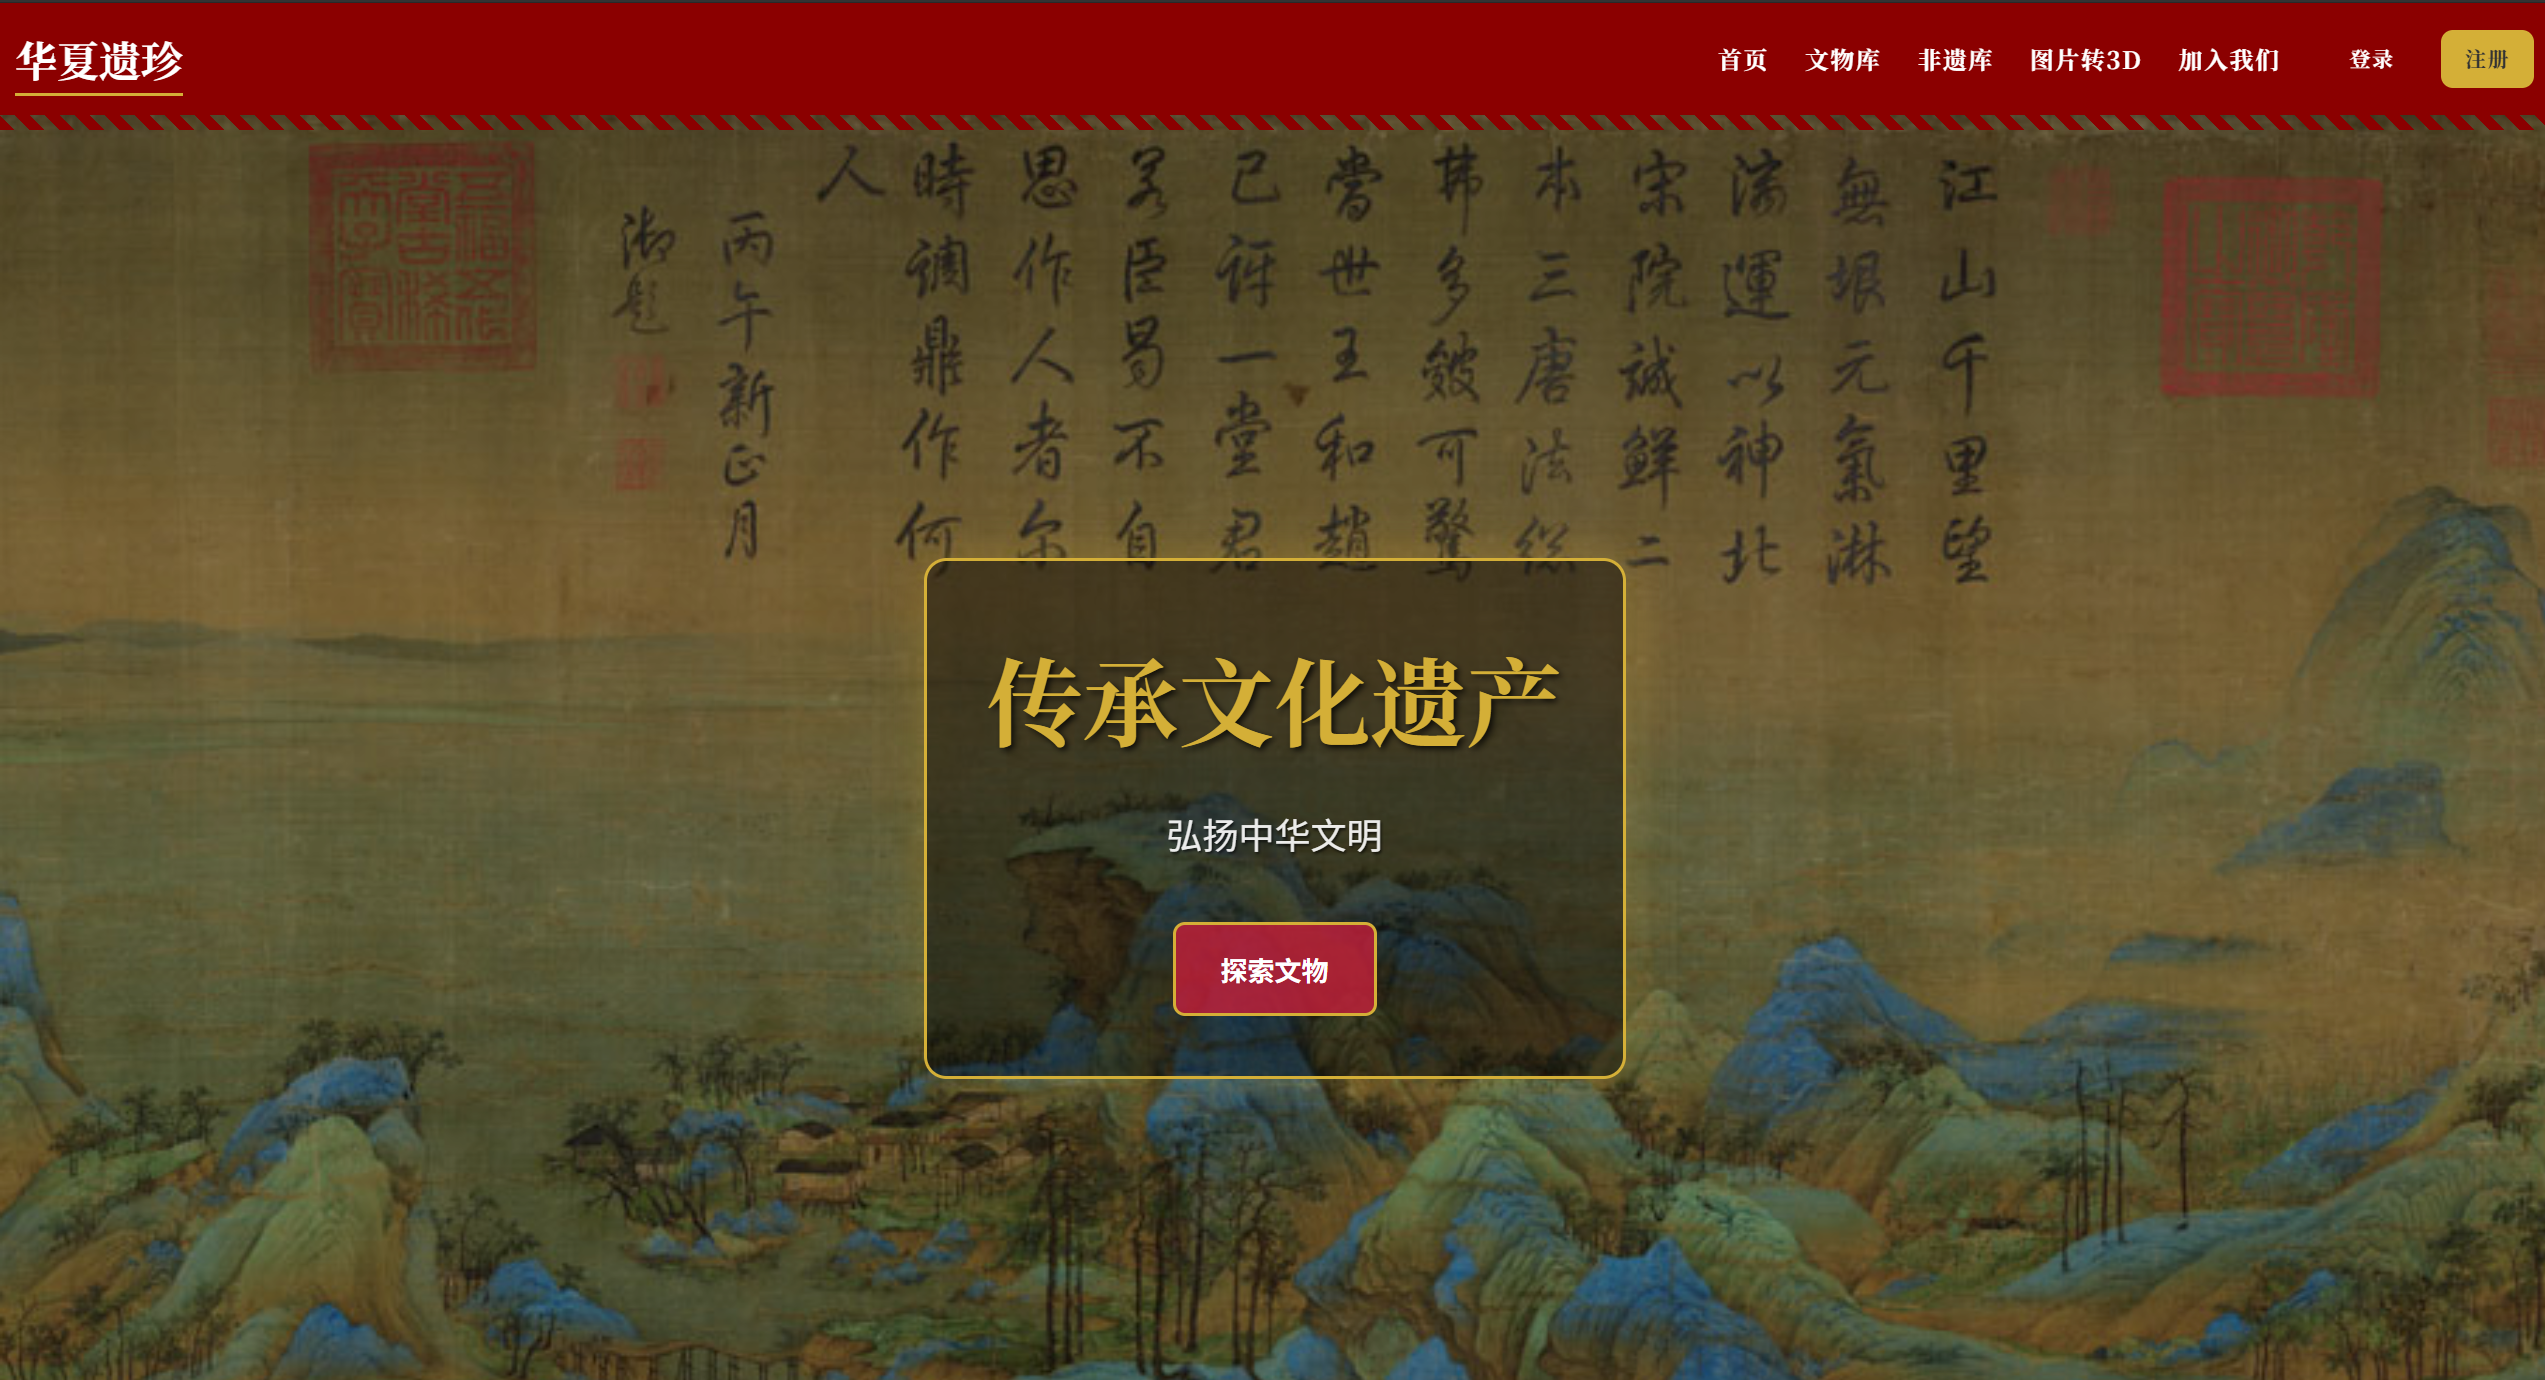
我们想做的事情,就是把文物资料、3D 模型和互动功能放到同一个网页中,让用户可以旋转、缩放模型,从不同角度观察器物的造型与纹理,同时阅读年代、材质、来源和详细介绍。
核心功能
文物与非遗数字资源库
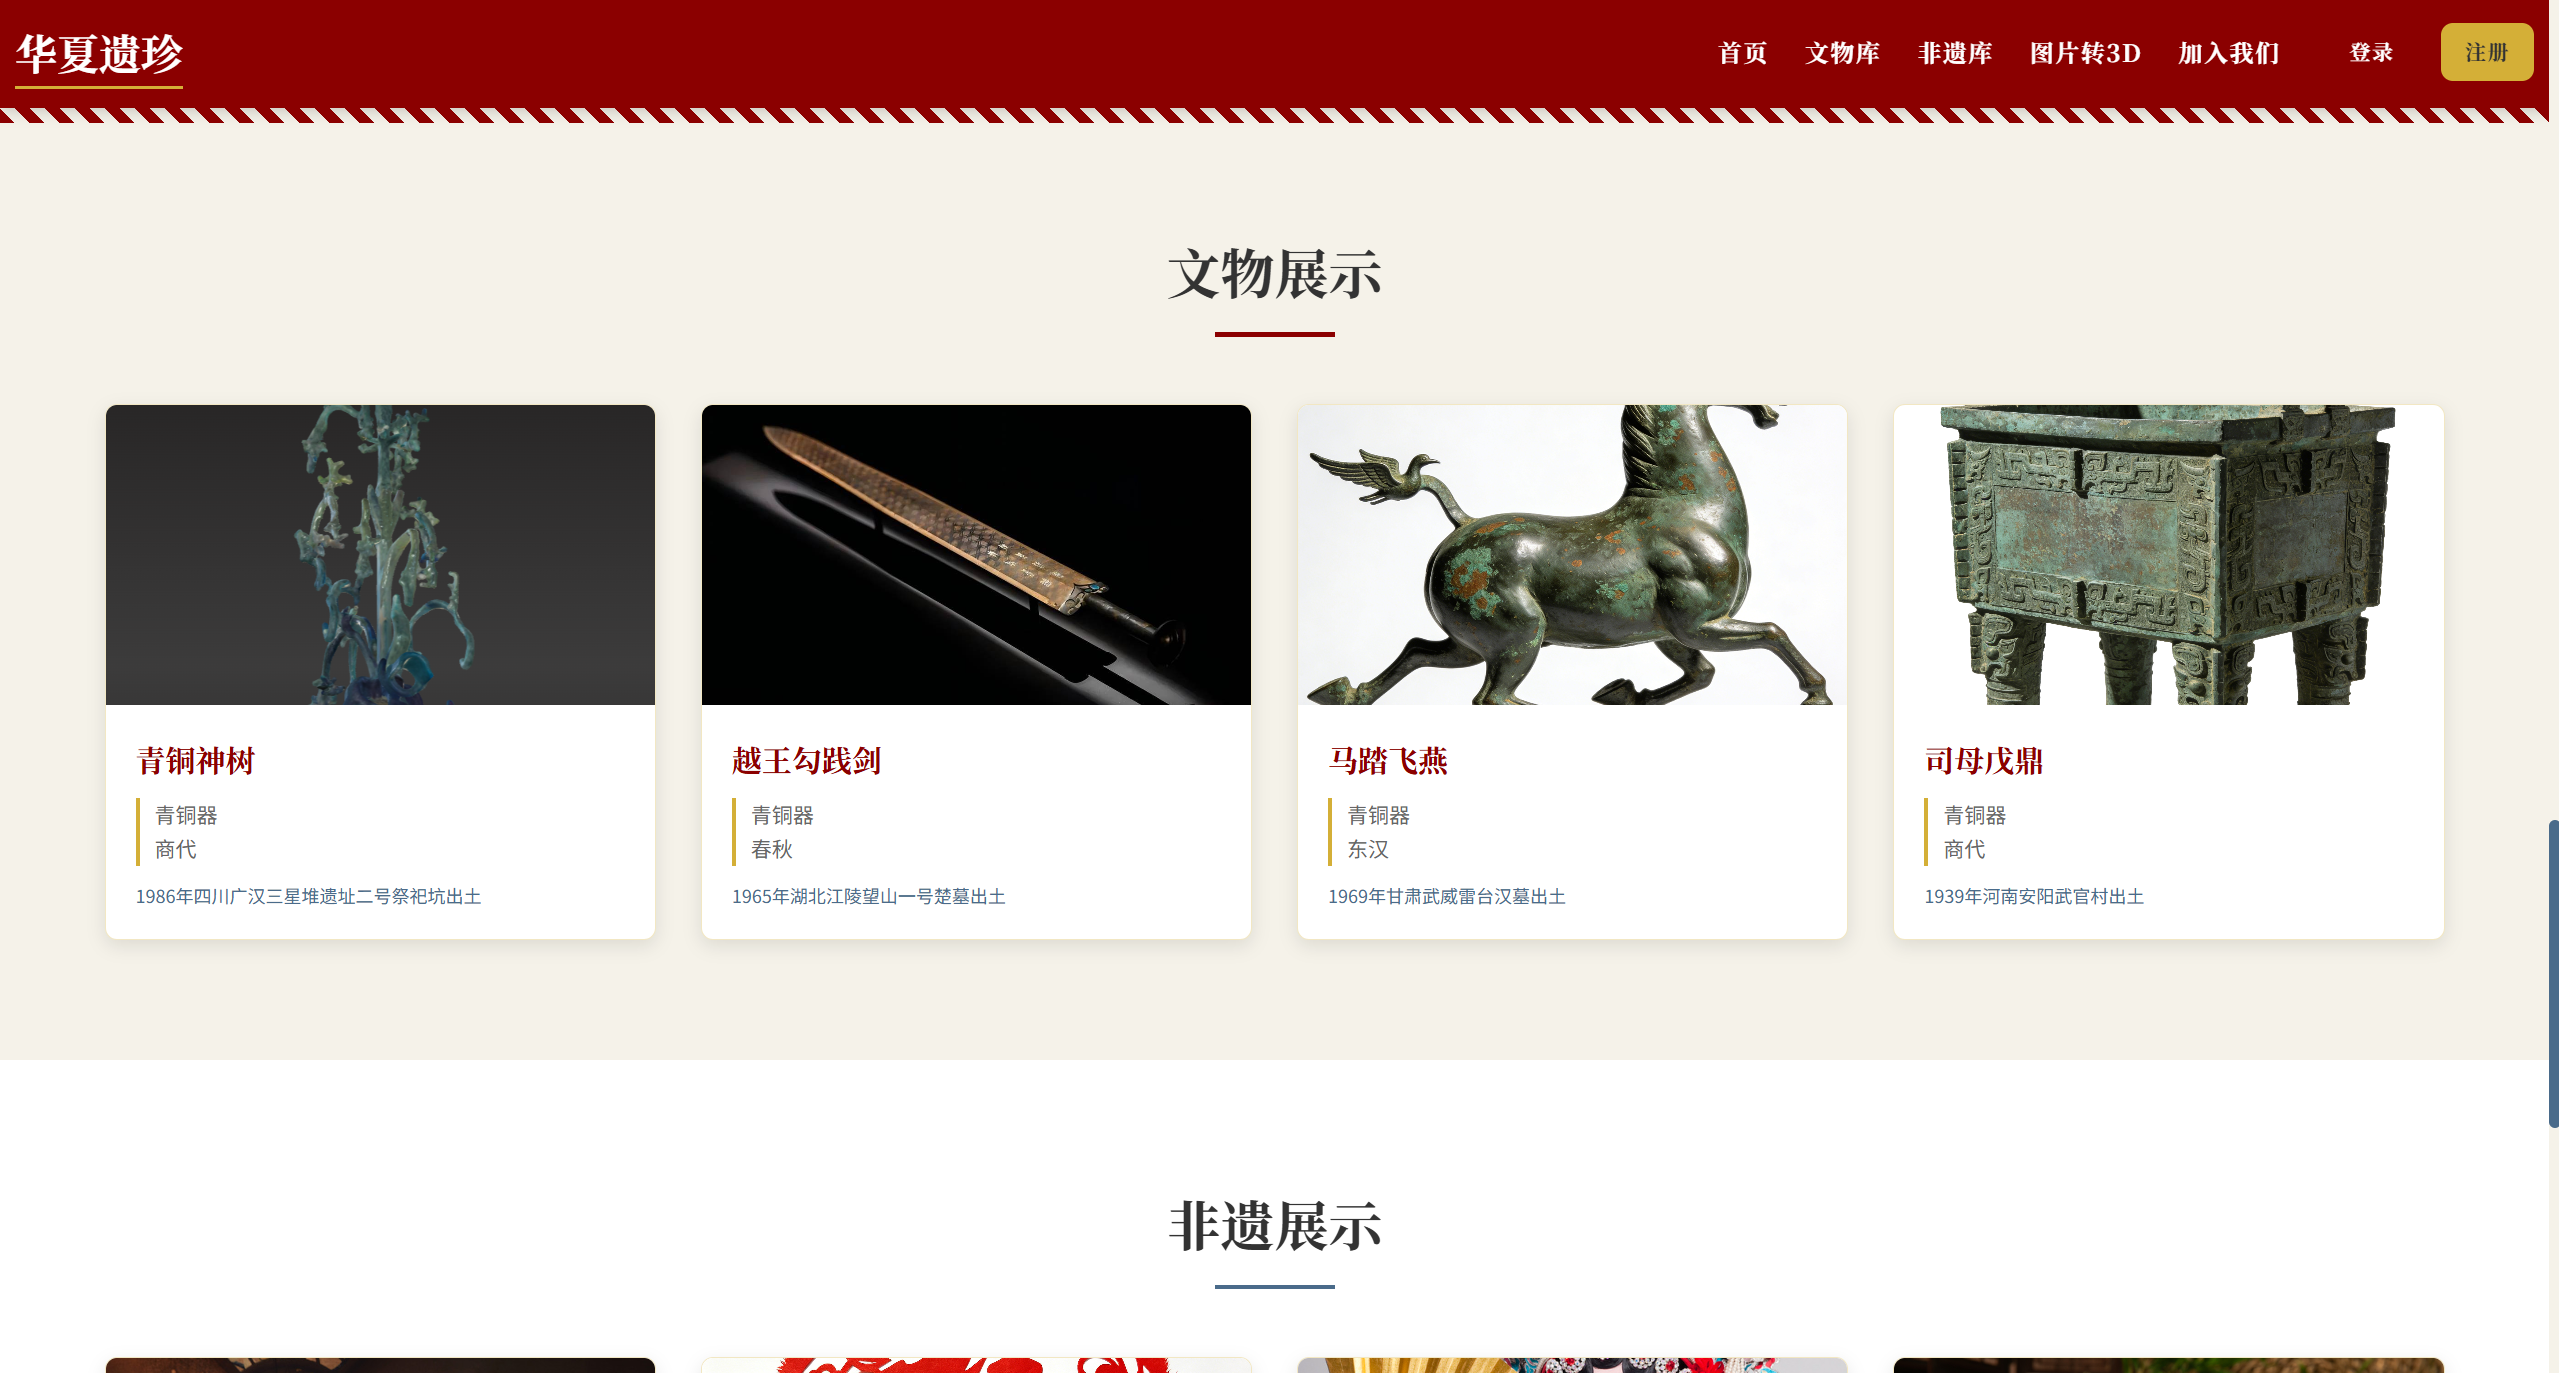
文物库按名称、类型等条件展示文物资料。进入详情页后,可以查看器物的年代、材质、尺寸、收藏单位、图文介绍及 3D 模型。对于不适合使用三维模型表现的书画类文物,页面会自动改用高清图片展示。
3D 模型浏览&AR查看
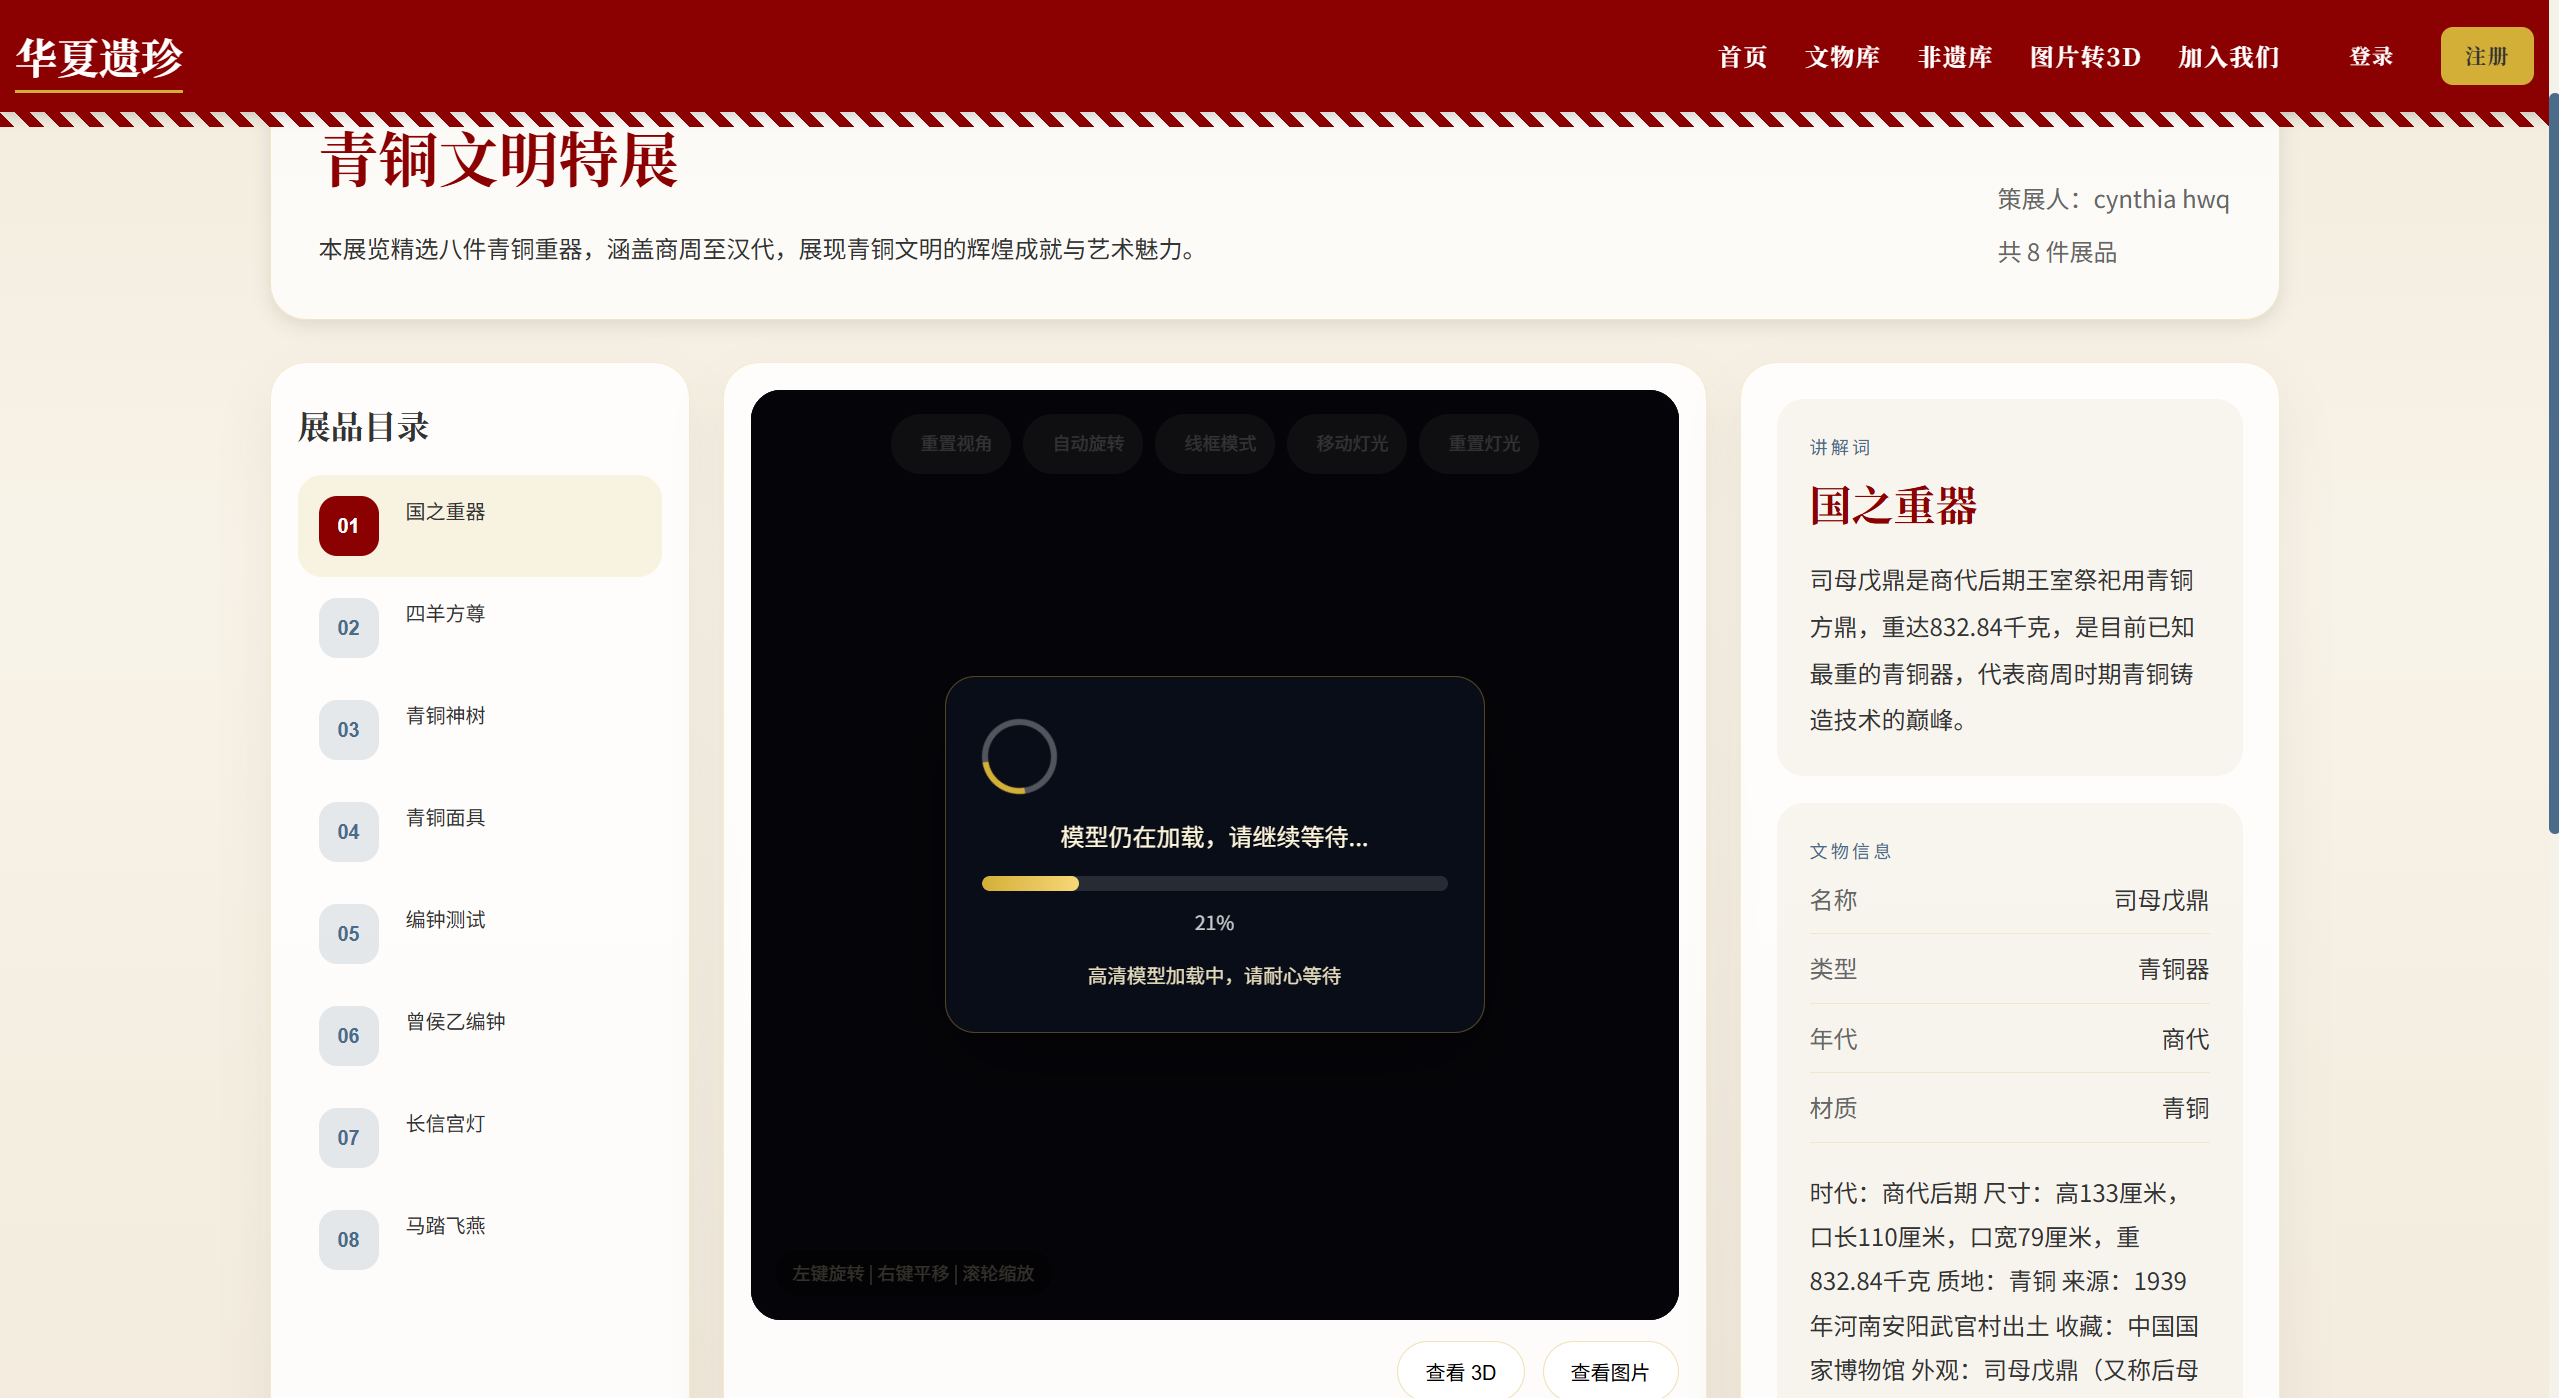
3D 查看器是项目最核心的部分。用户可以使用鼠标旋转、平移和缩放模型,也可以开启自动旋转、切换线框模式、移动光源并调整光照强度。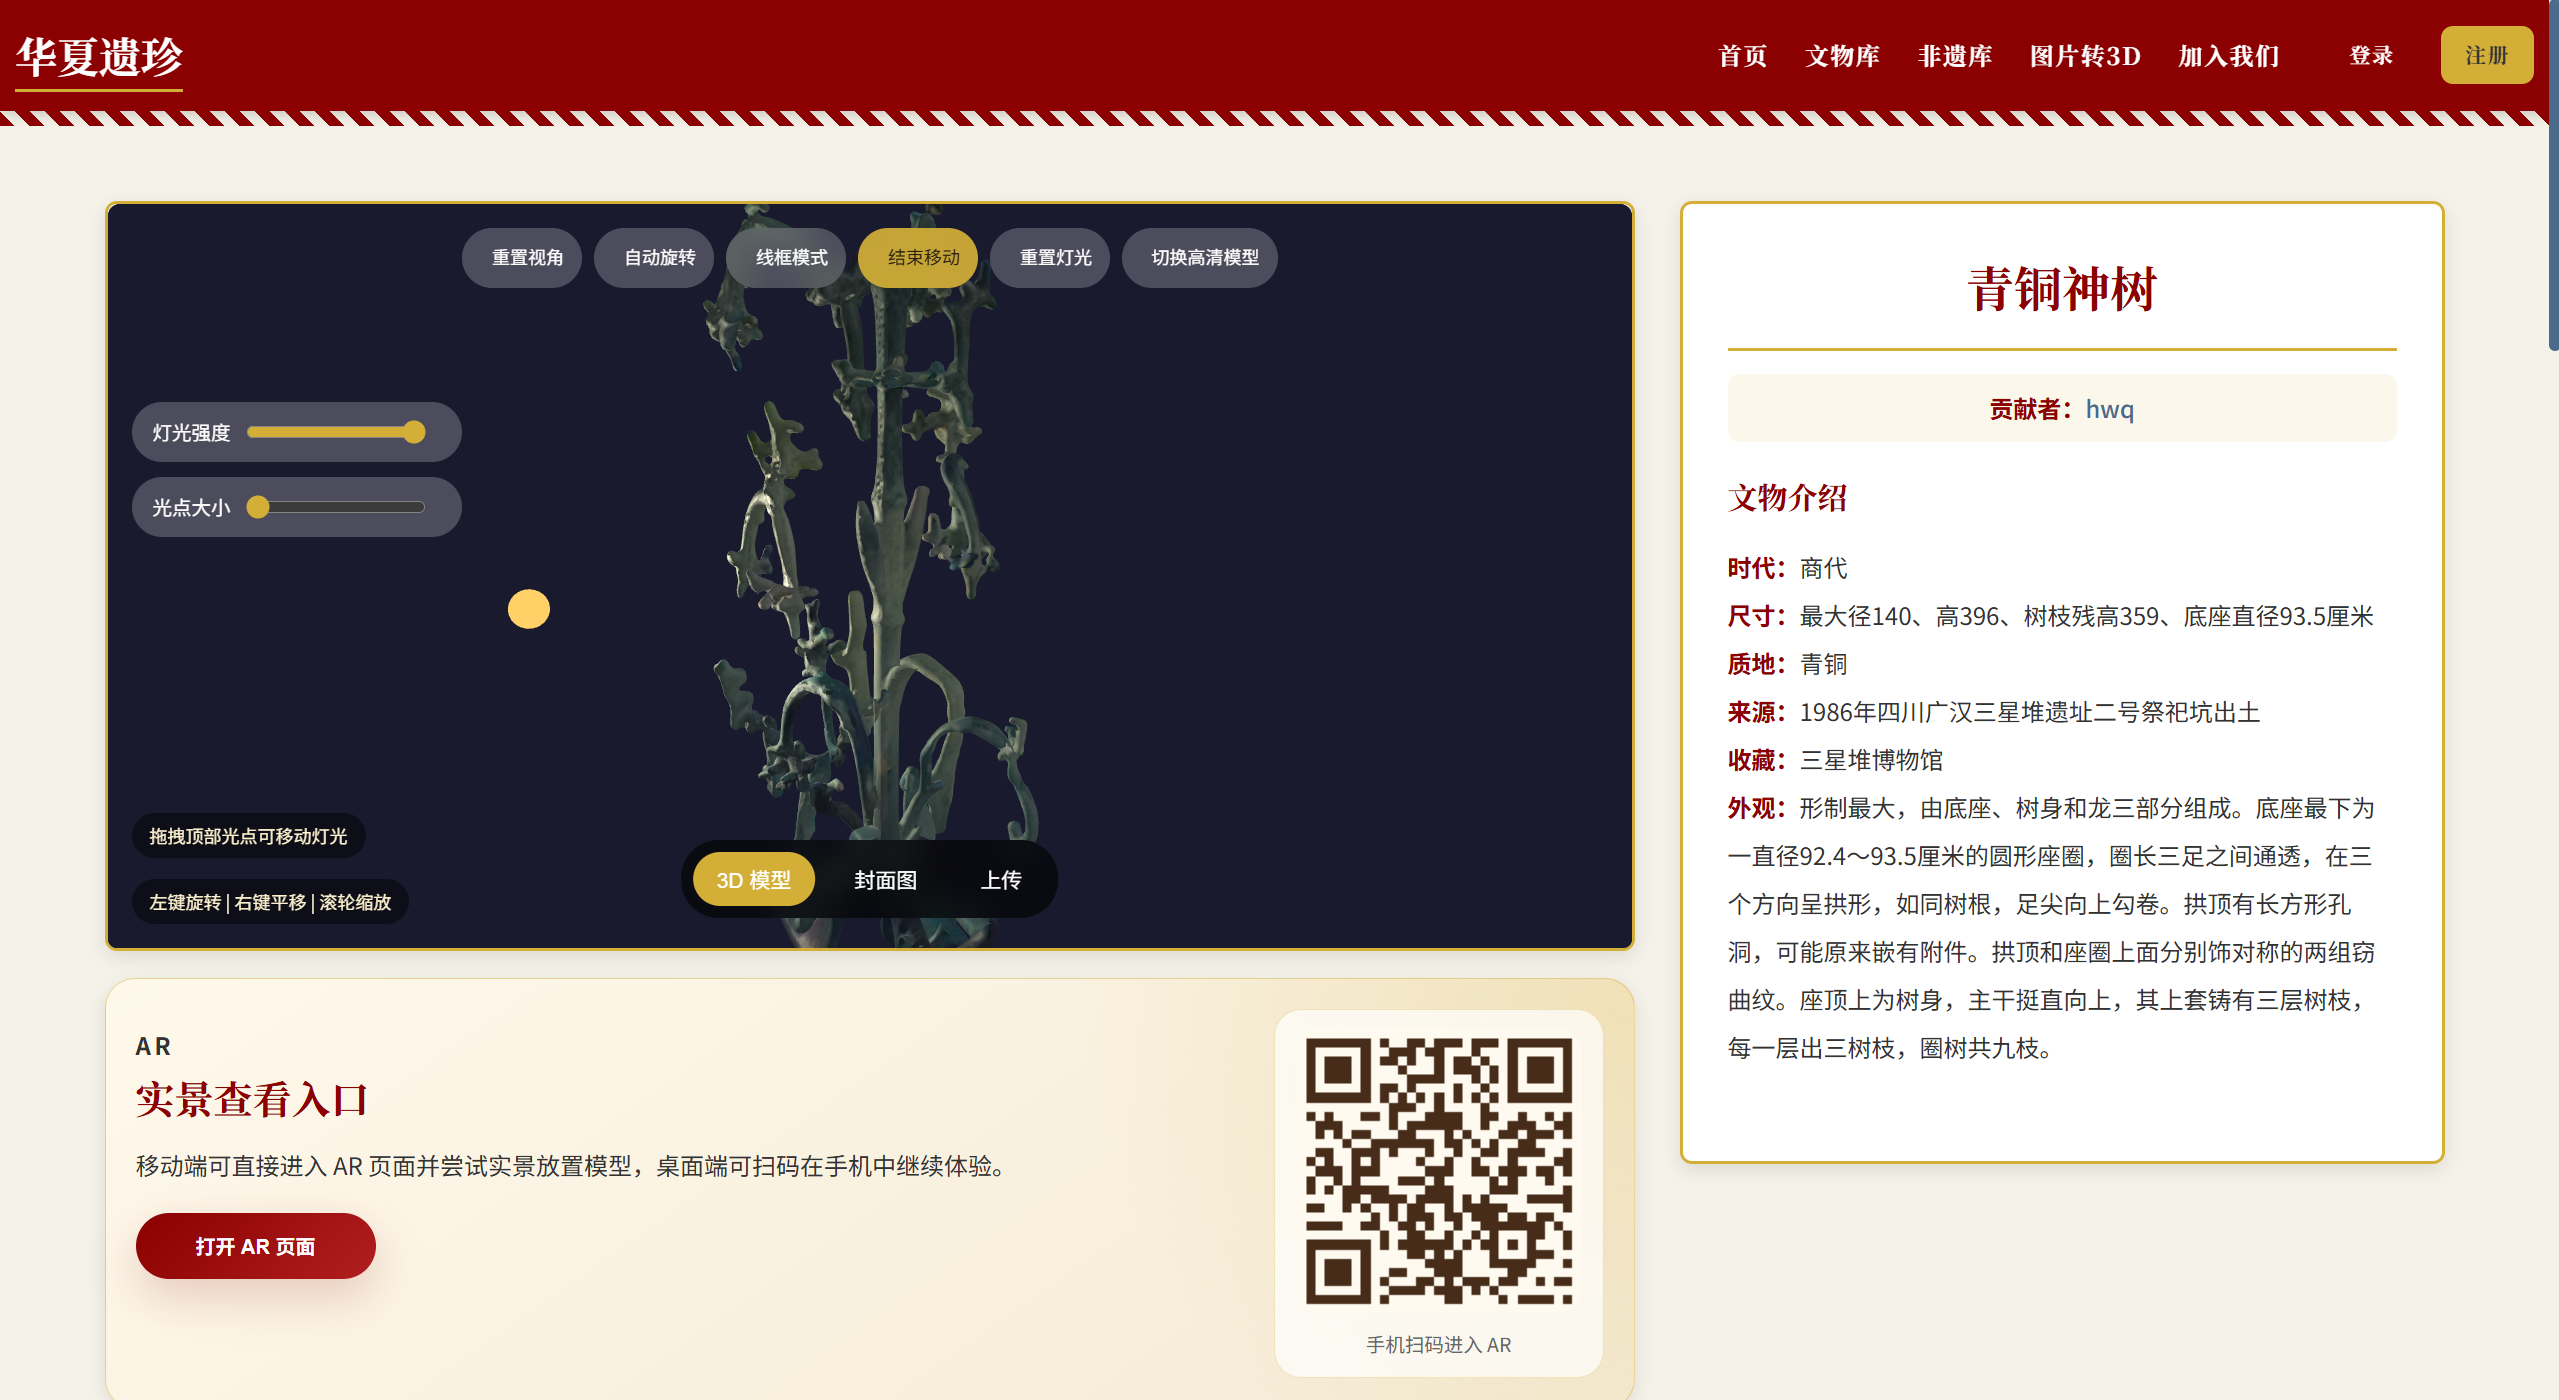
详情页默认优先加载体积较小的快速模型,用户需要观察细节时再主动切换高清模型。移动端还可以进入 AR 页面,将模型放到真实环境中查看;桌面端则提供模拟 AR 模式,方便在没有手机相机的情况下体验相同的浏览流程。
主题展厅与 AI 导览
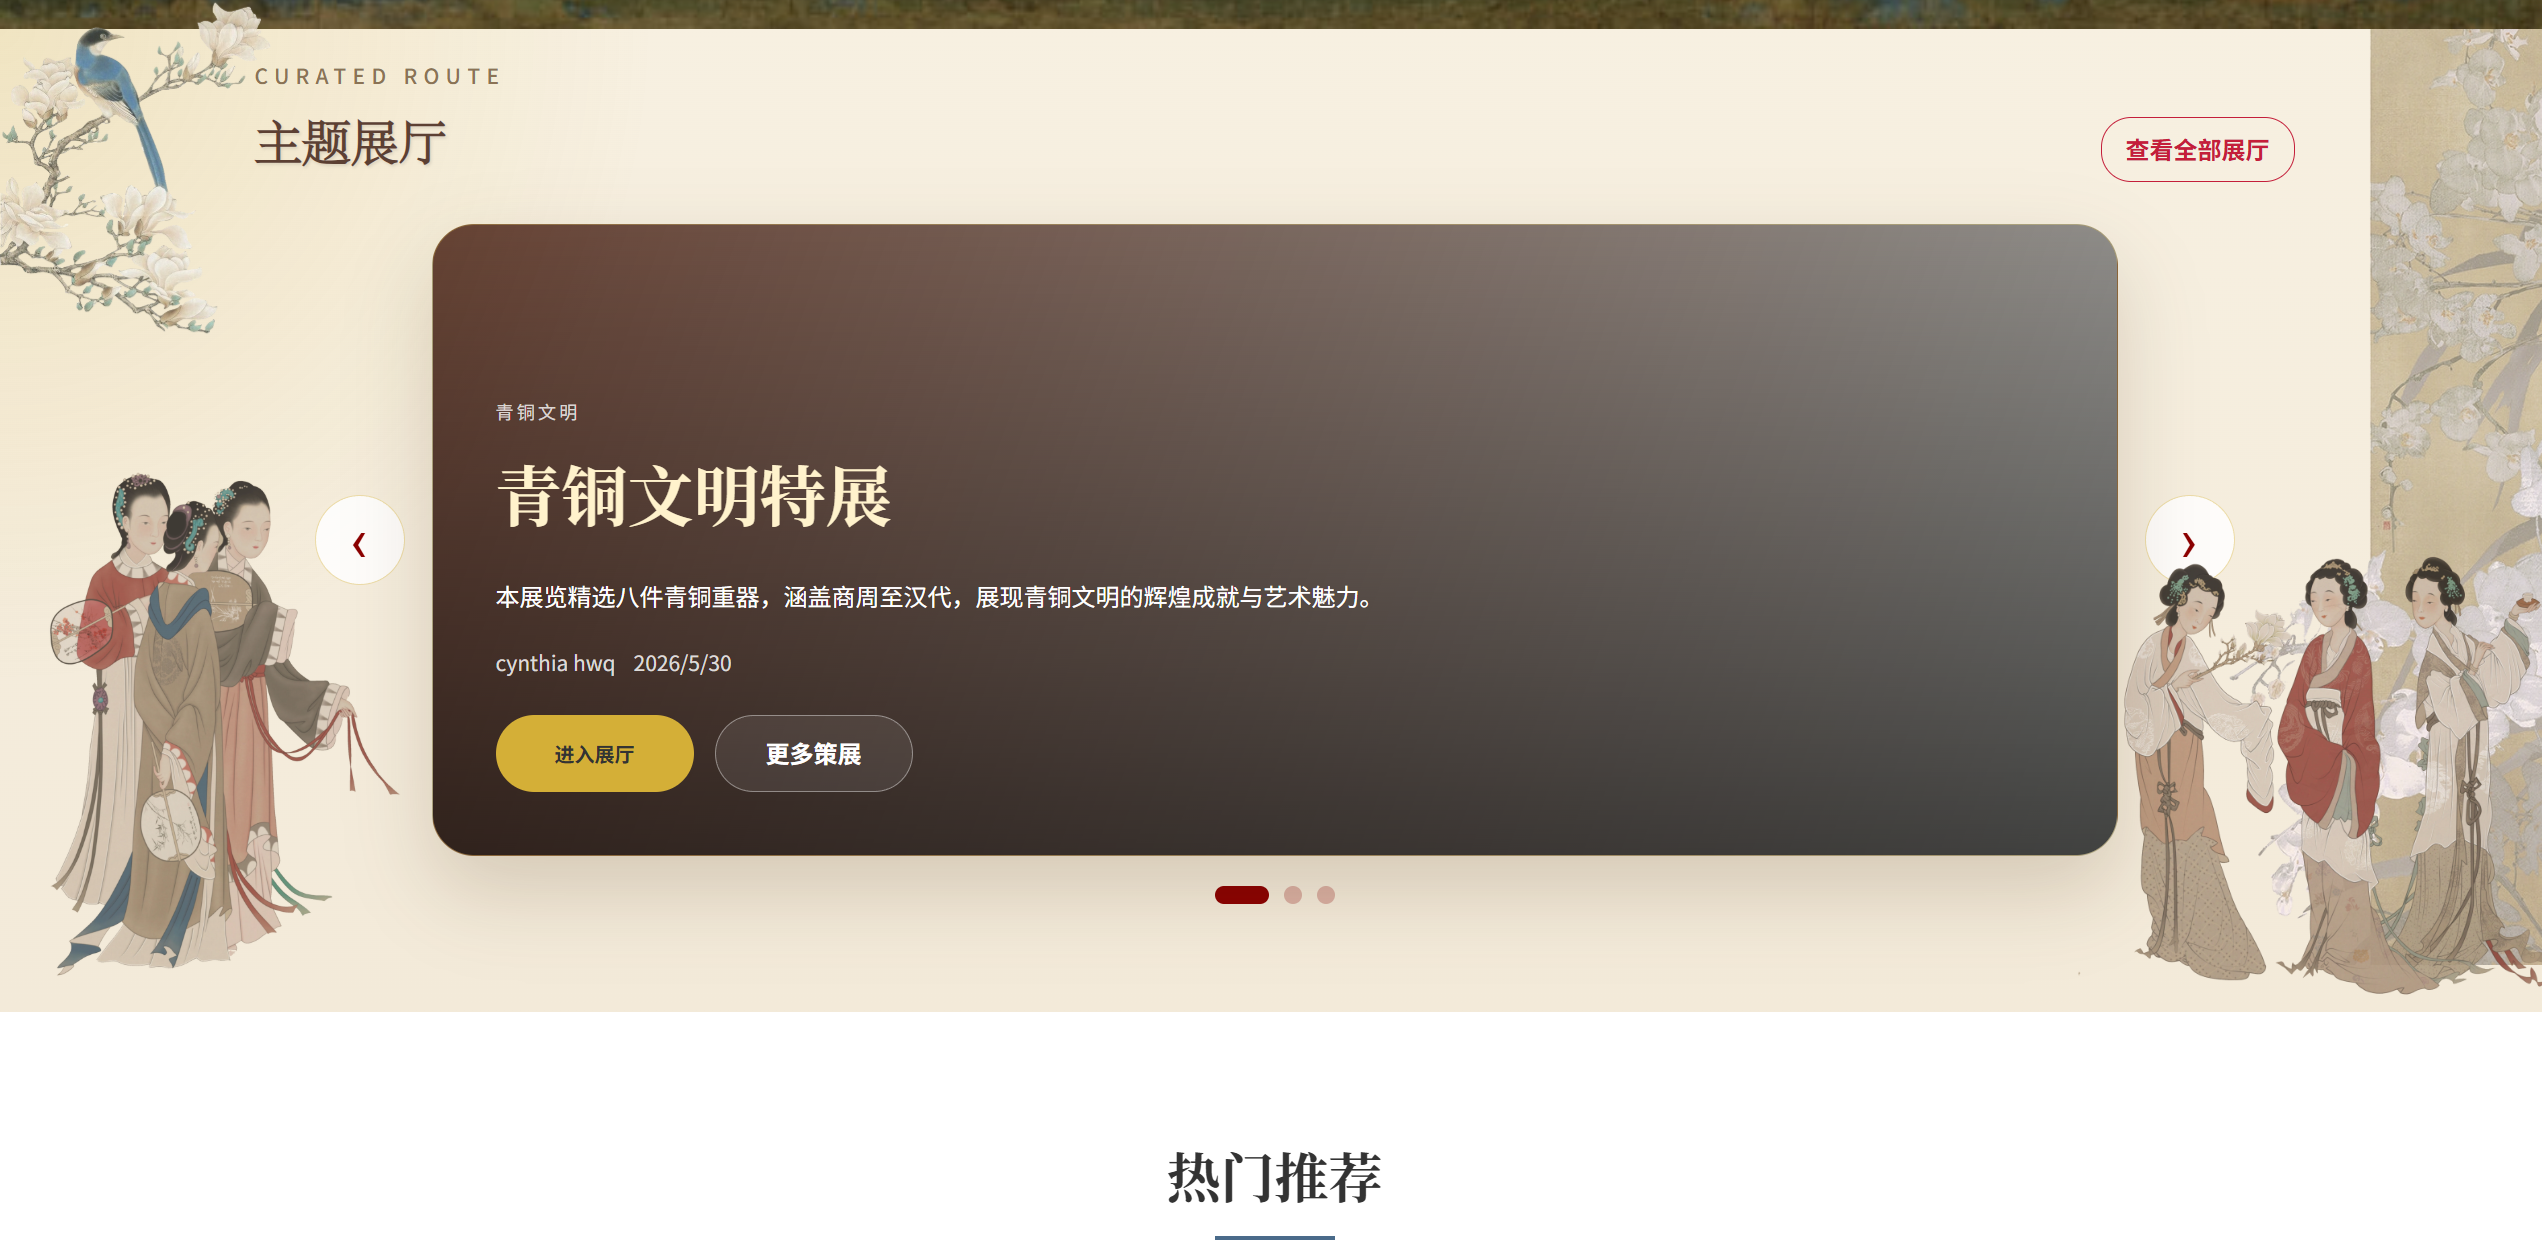
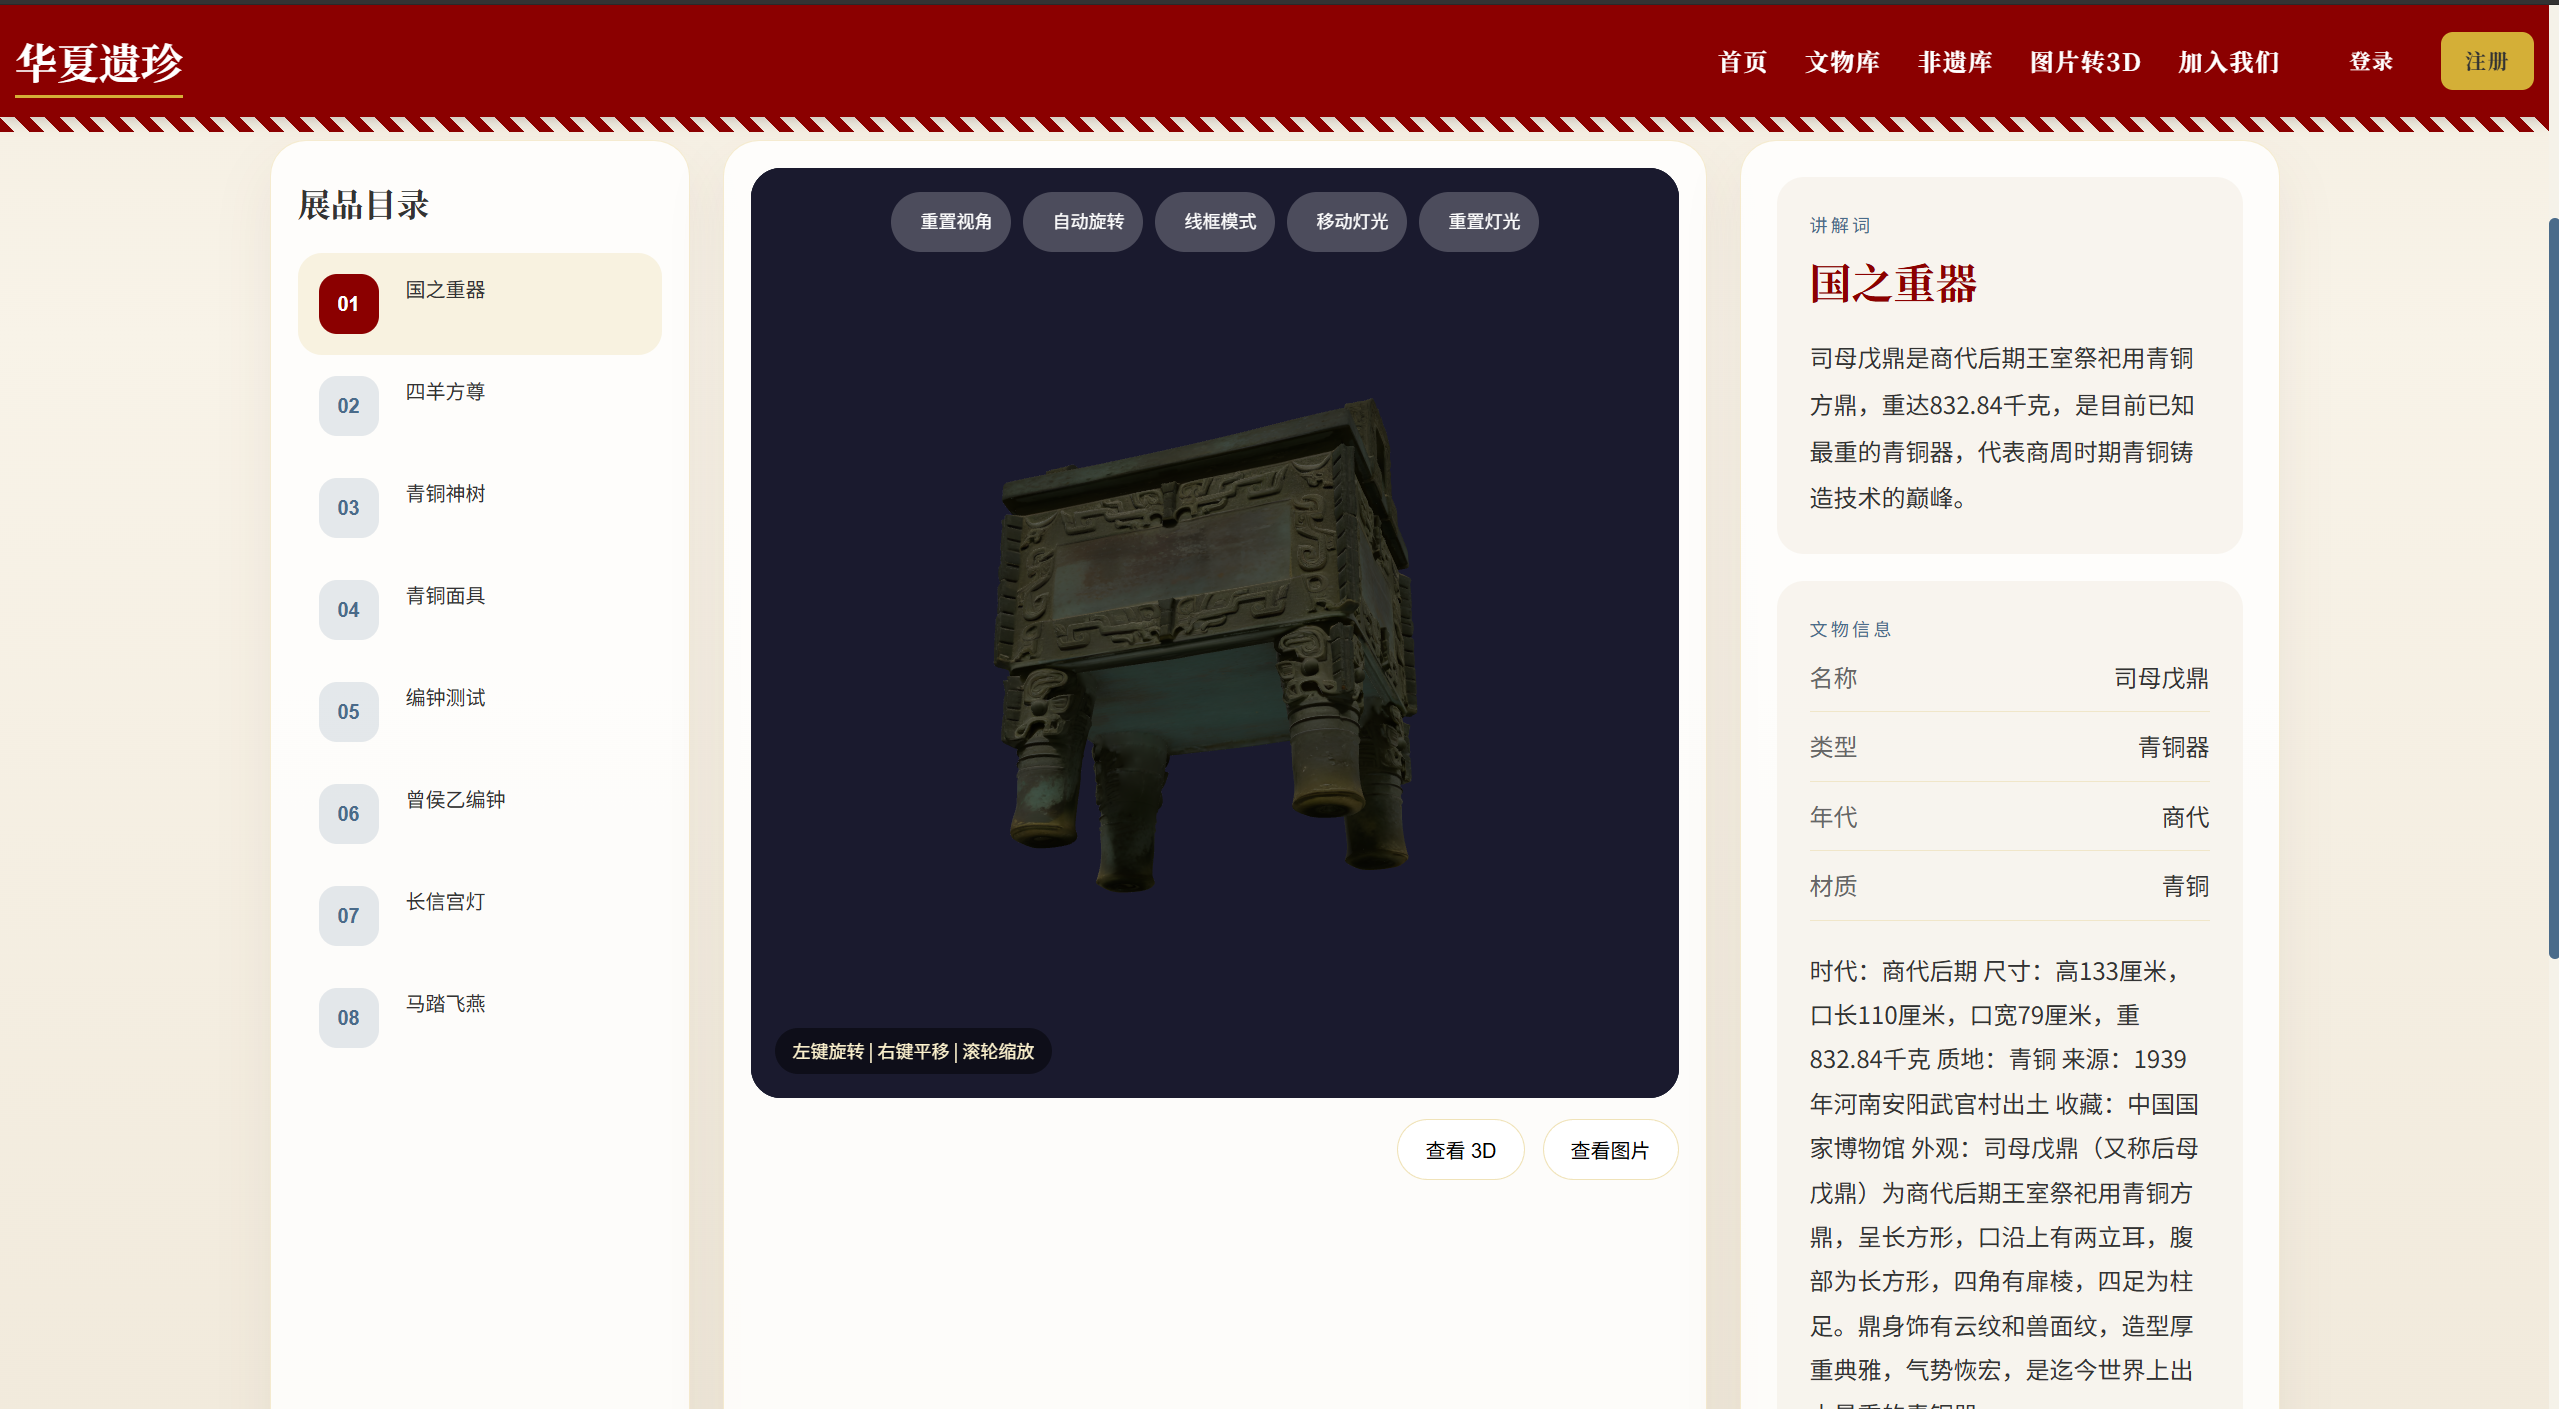
围绕一个主题组织参展文物、展览顺序和讲解词。
管理员可以创建展览、选择展品并调整顺序,也可以让 AI 根据主题和候选文物生成策展草稿,再进行人工修改。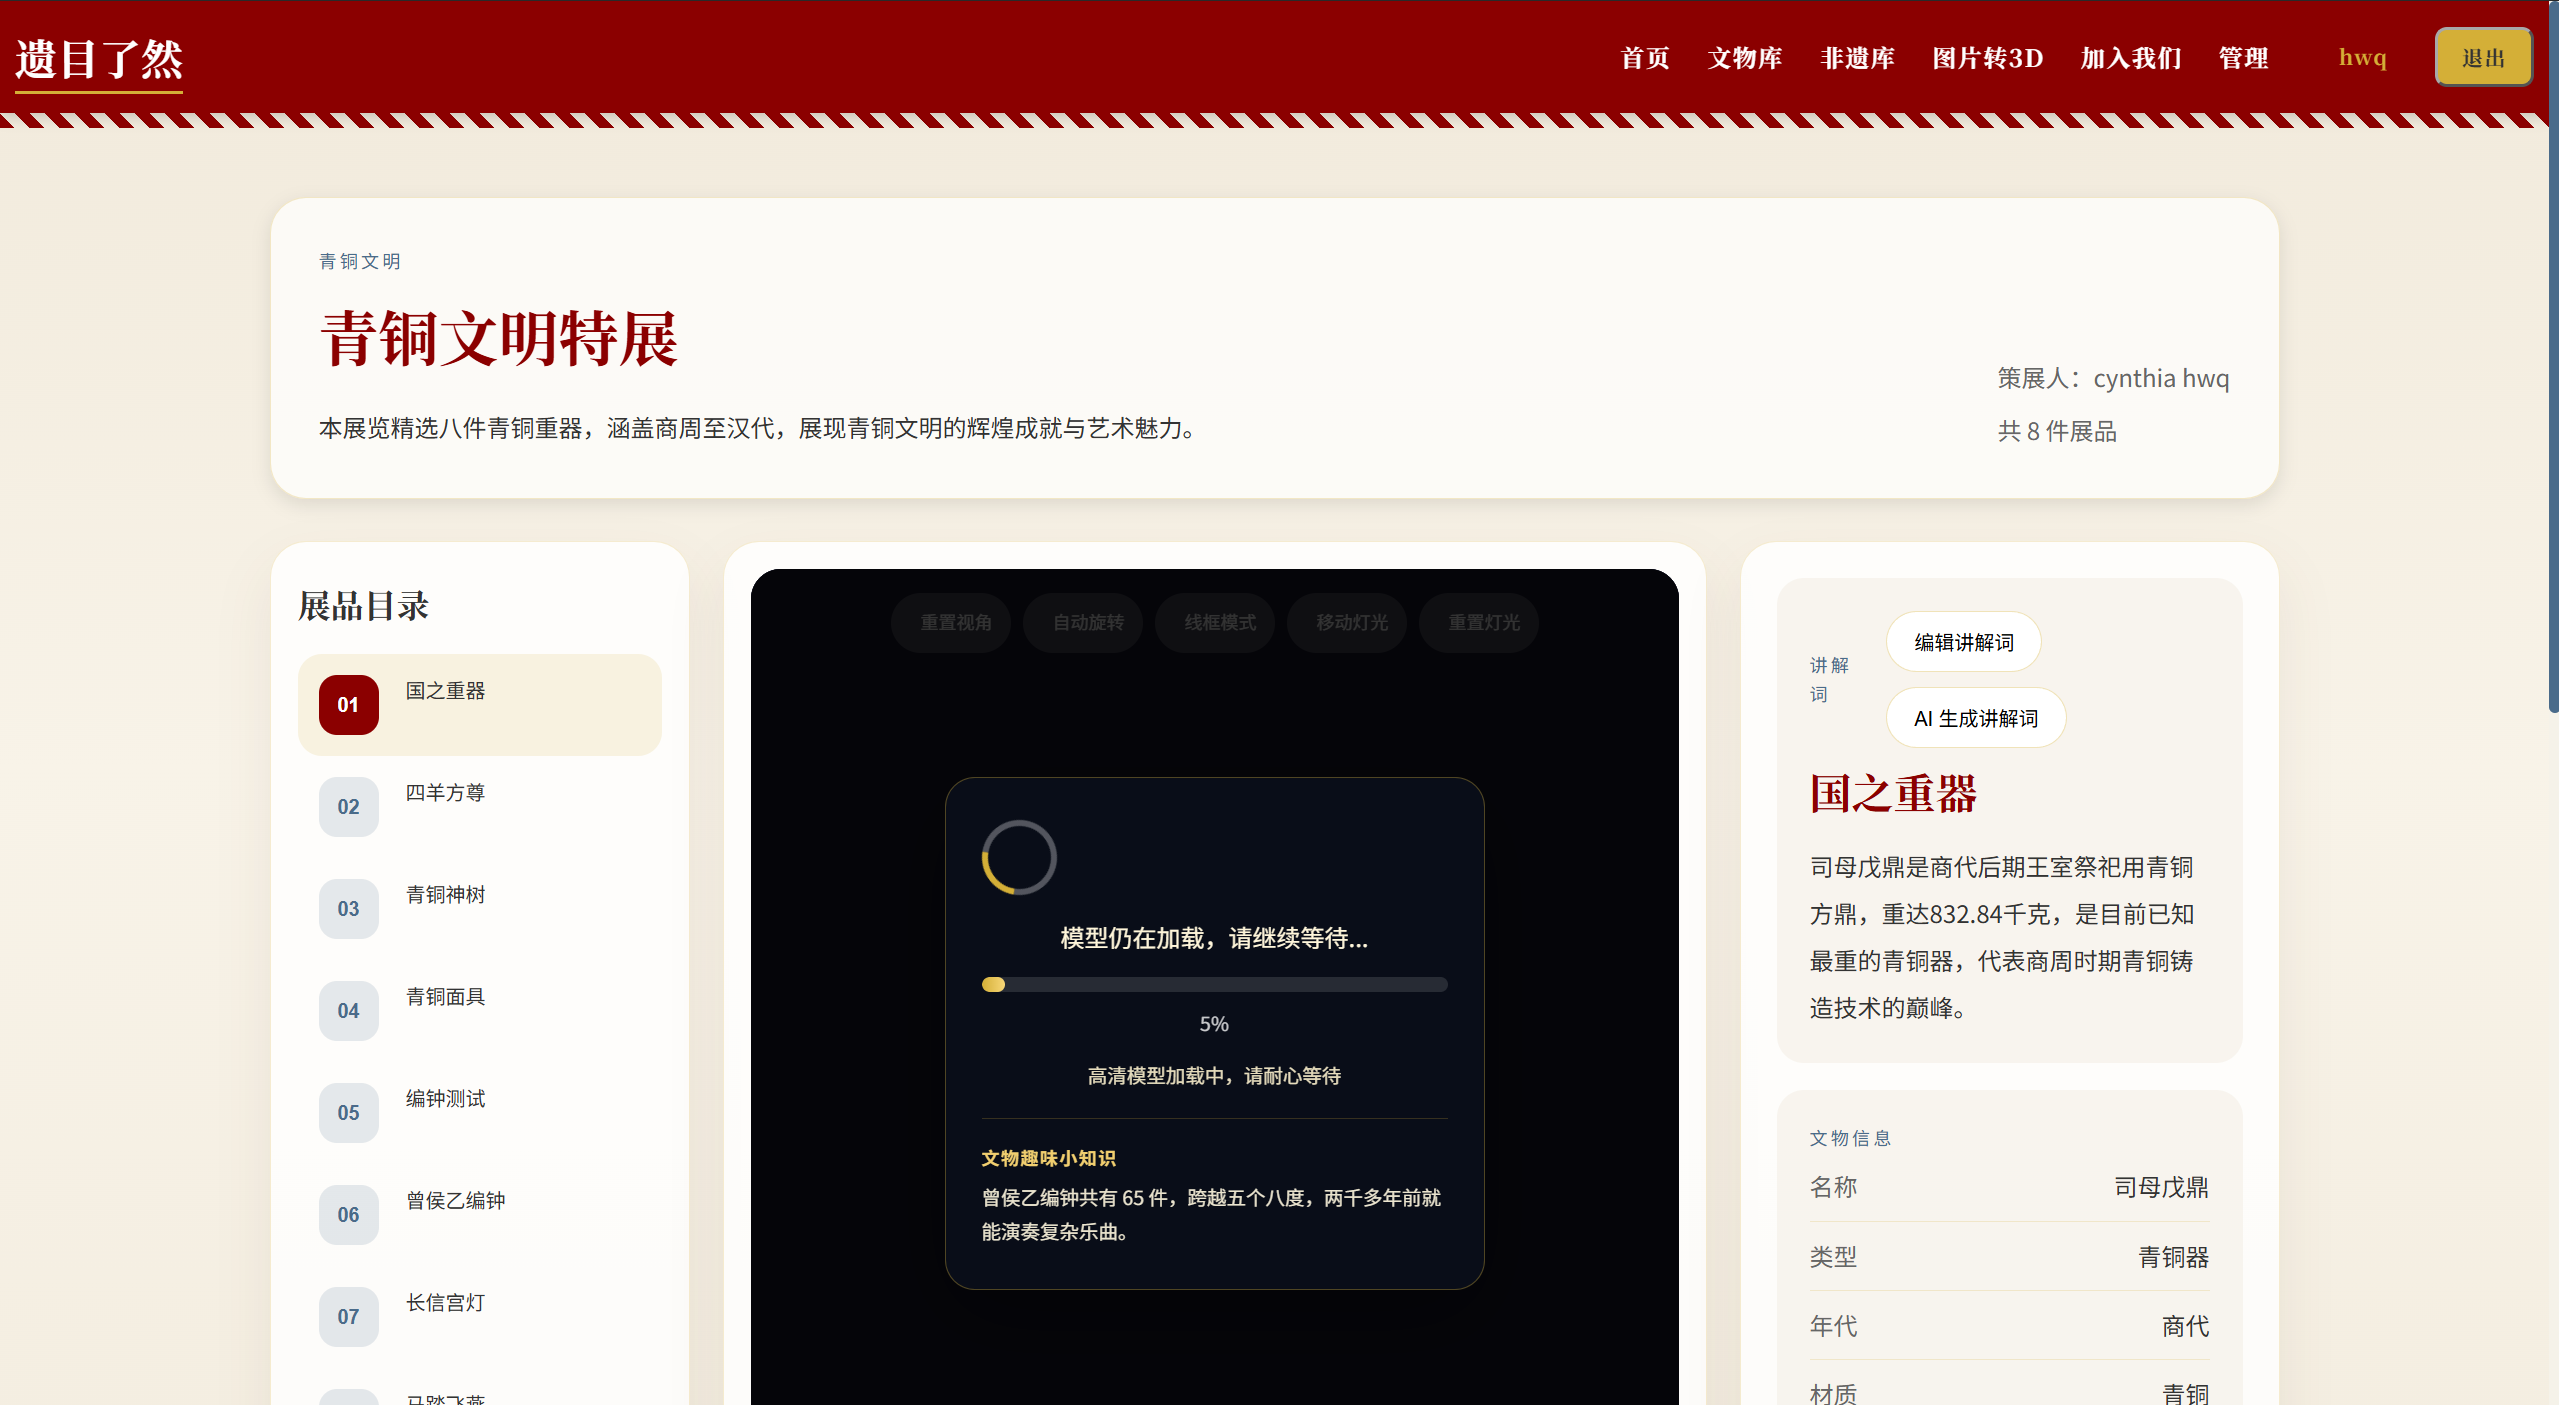
用户互动与内容共建
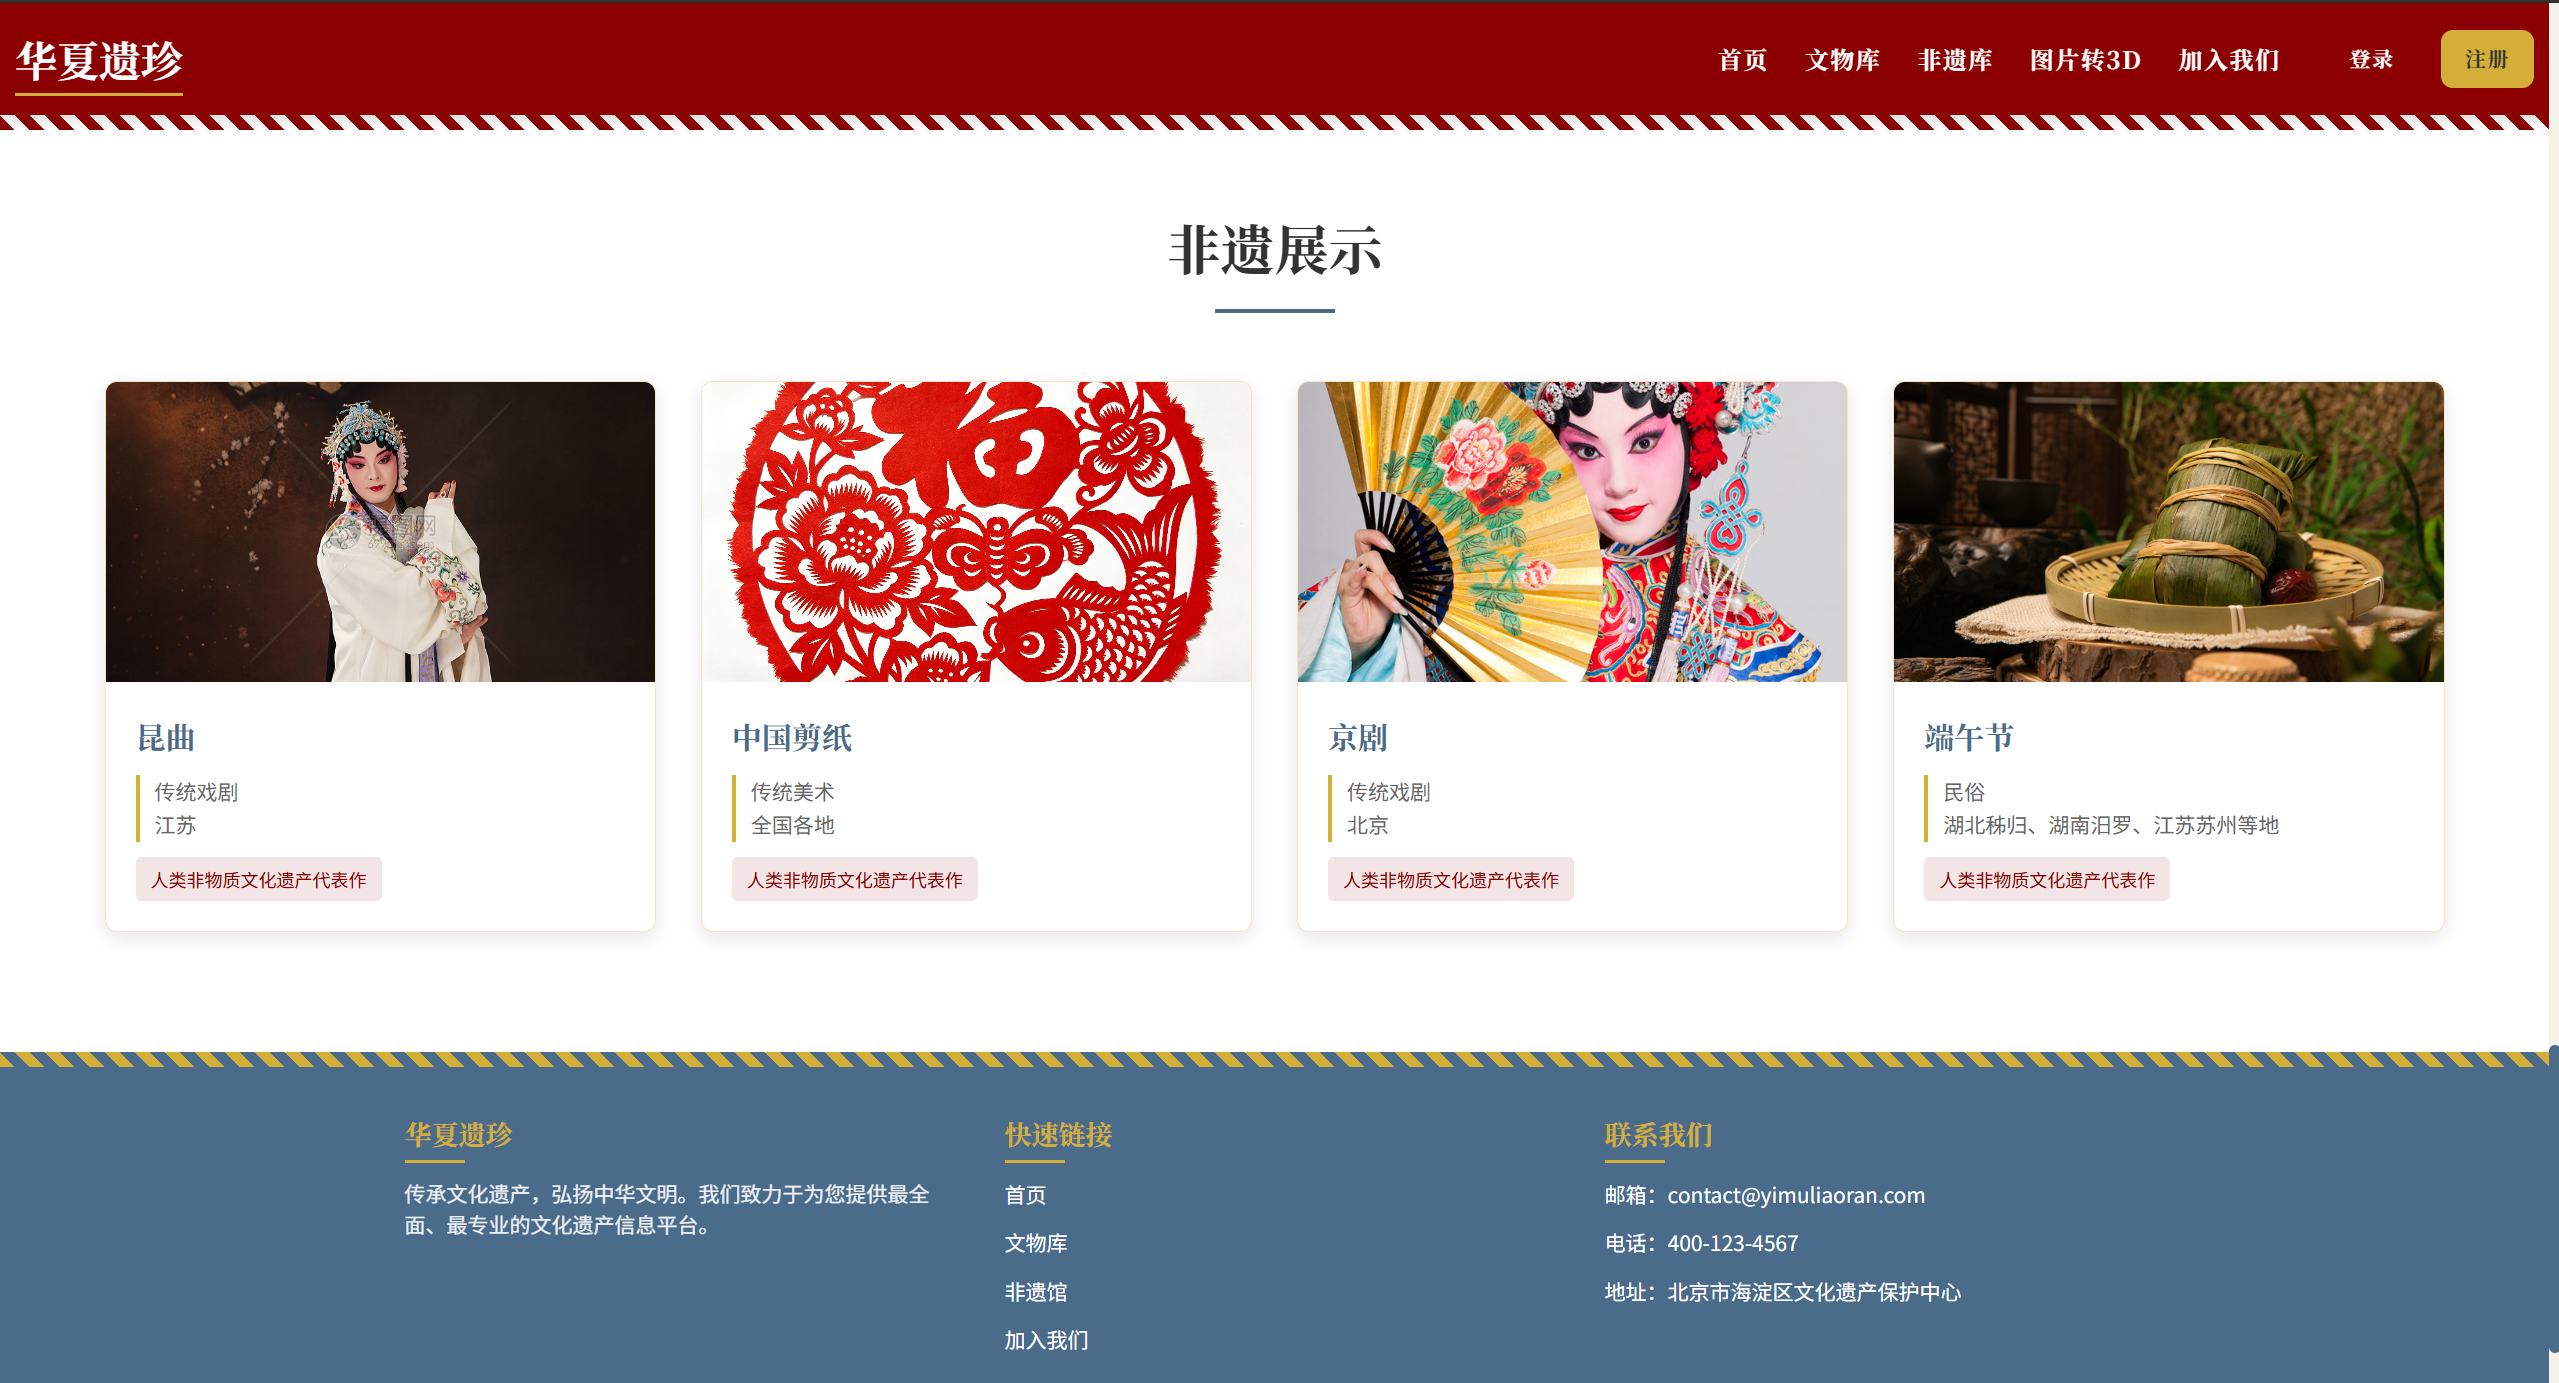
注册用户可以对文物和非遗项目点赞、收藏和评论,并在个人中心查看自己的收藏、评论和投稿记录。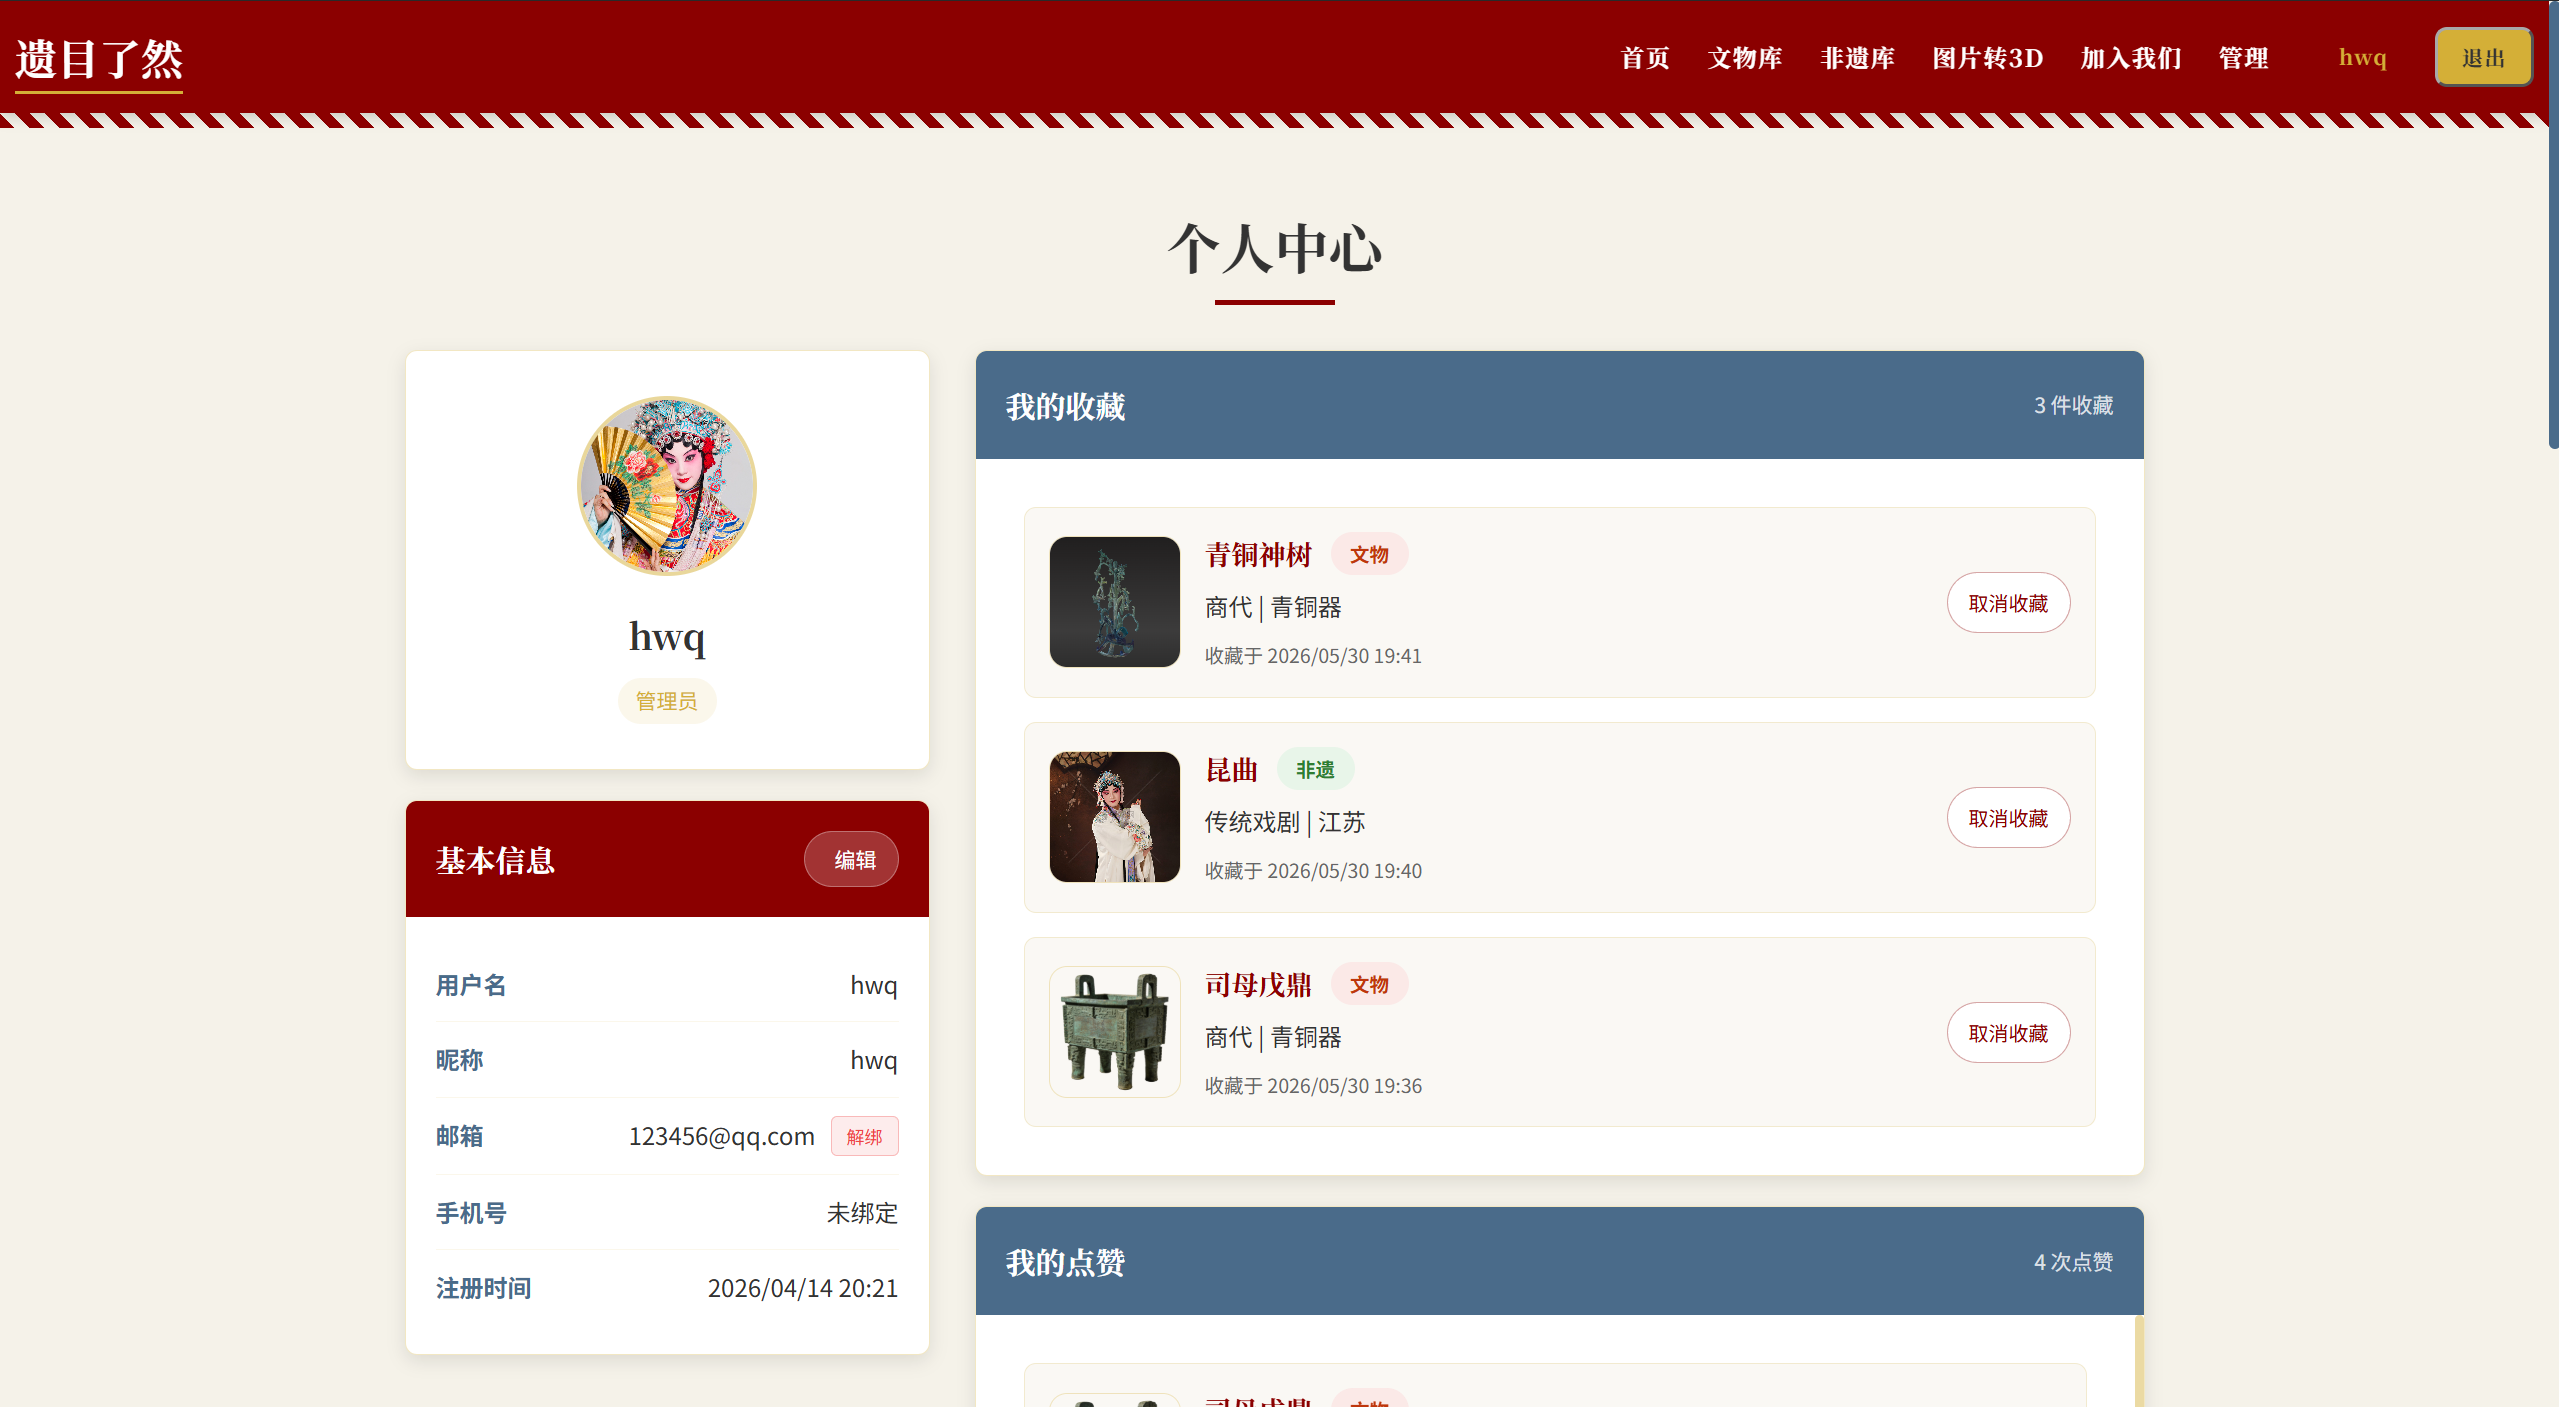
平台也提供内容共建入口,允许用户提交文物或非遗资料,并上传封面、相关图片和 GLB 模型。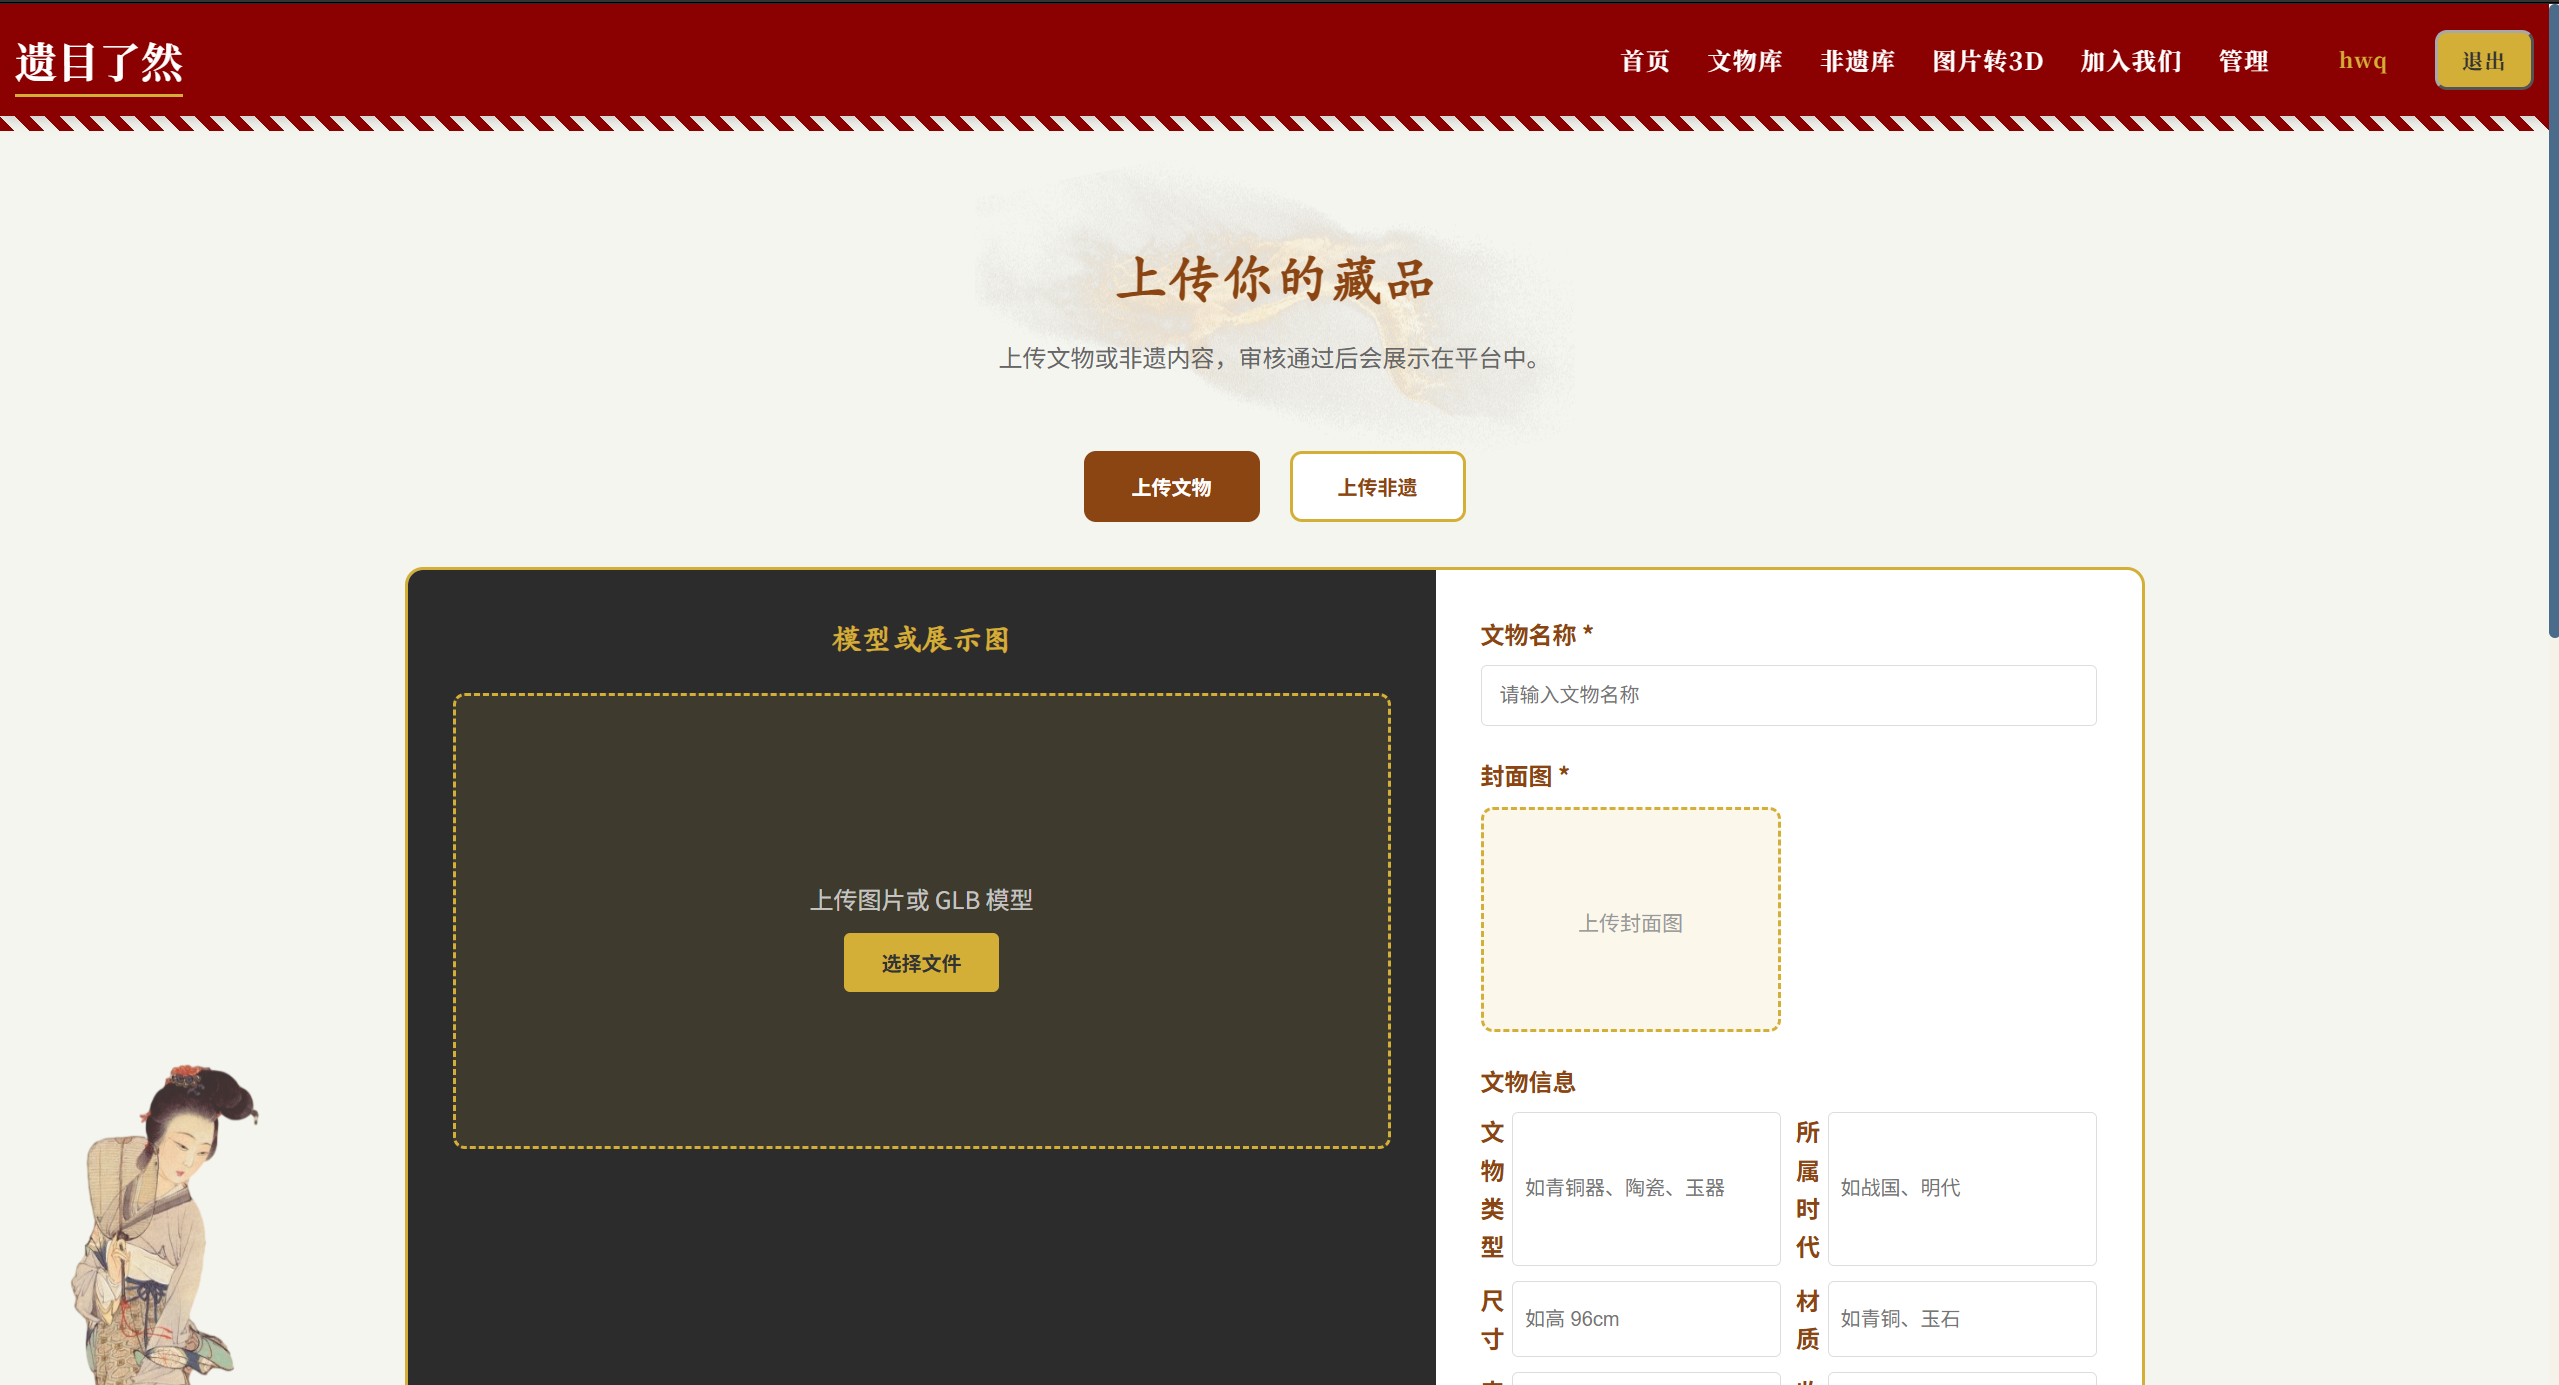
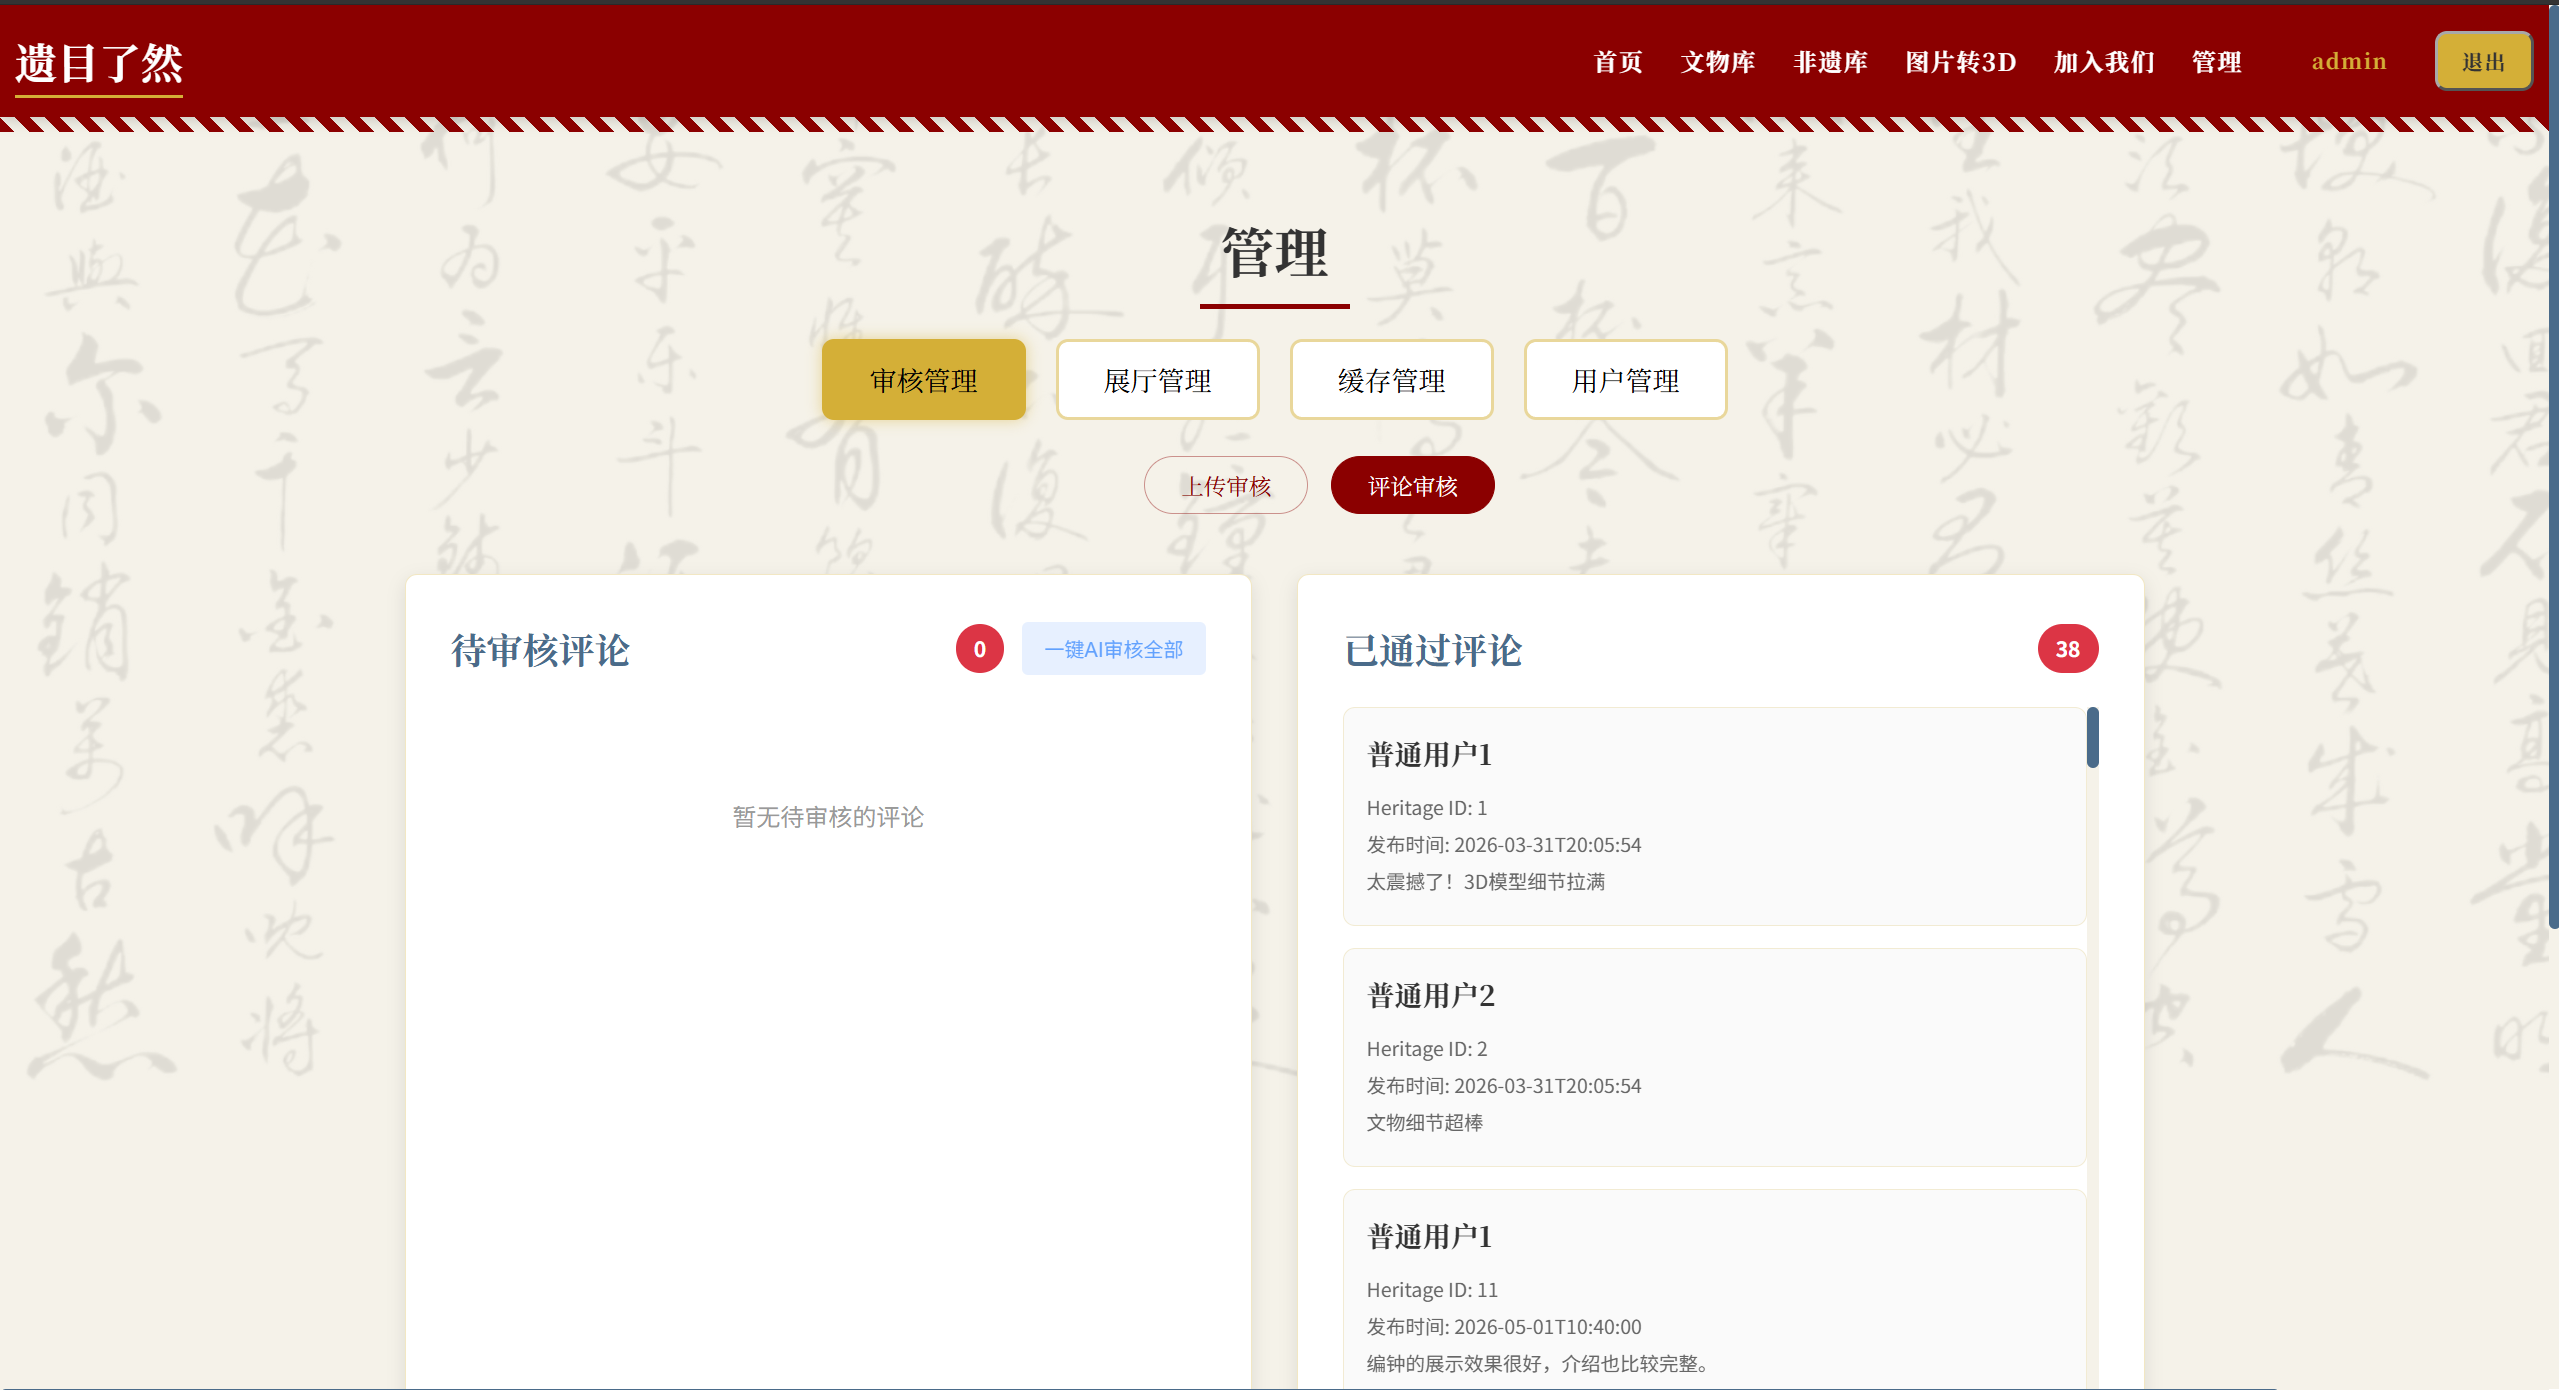
用户投稿不会直接公开,而是先进入待审核状态。管理员可以通过或驳回投稿,并填写驳回原因;评论同样需要审核,同时支持调用 AI 进行单条或批量初审。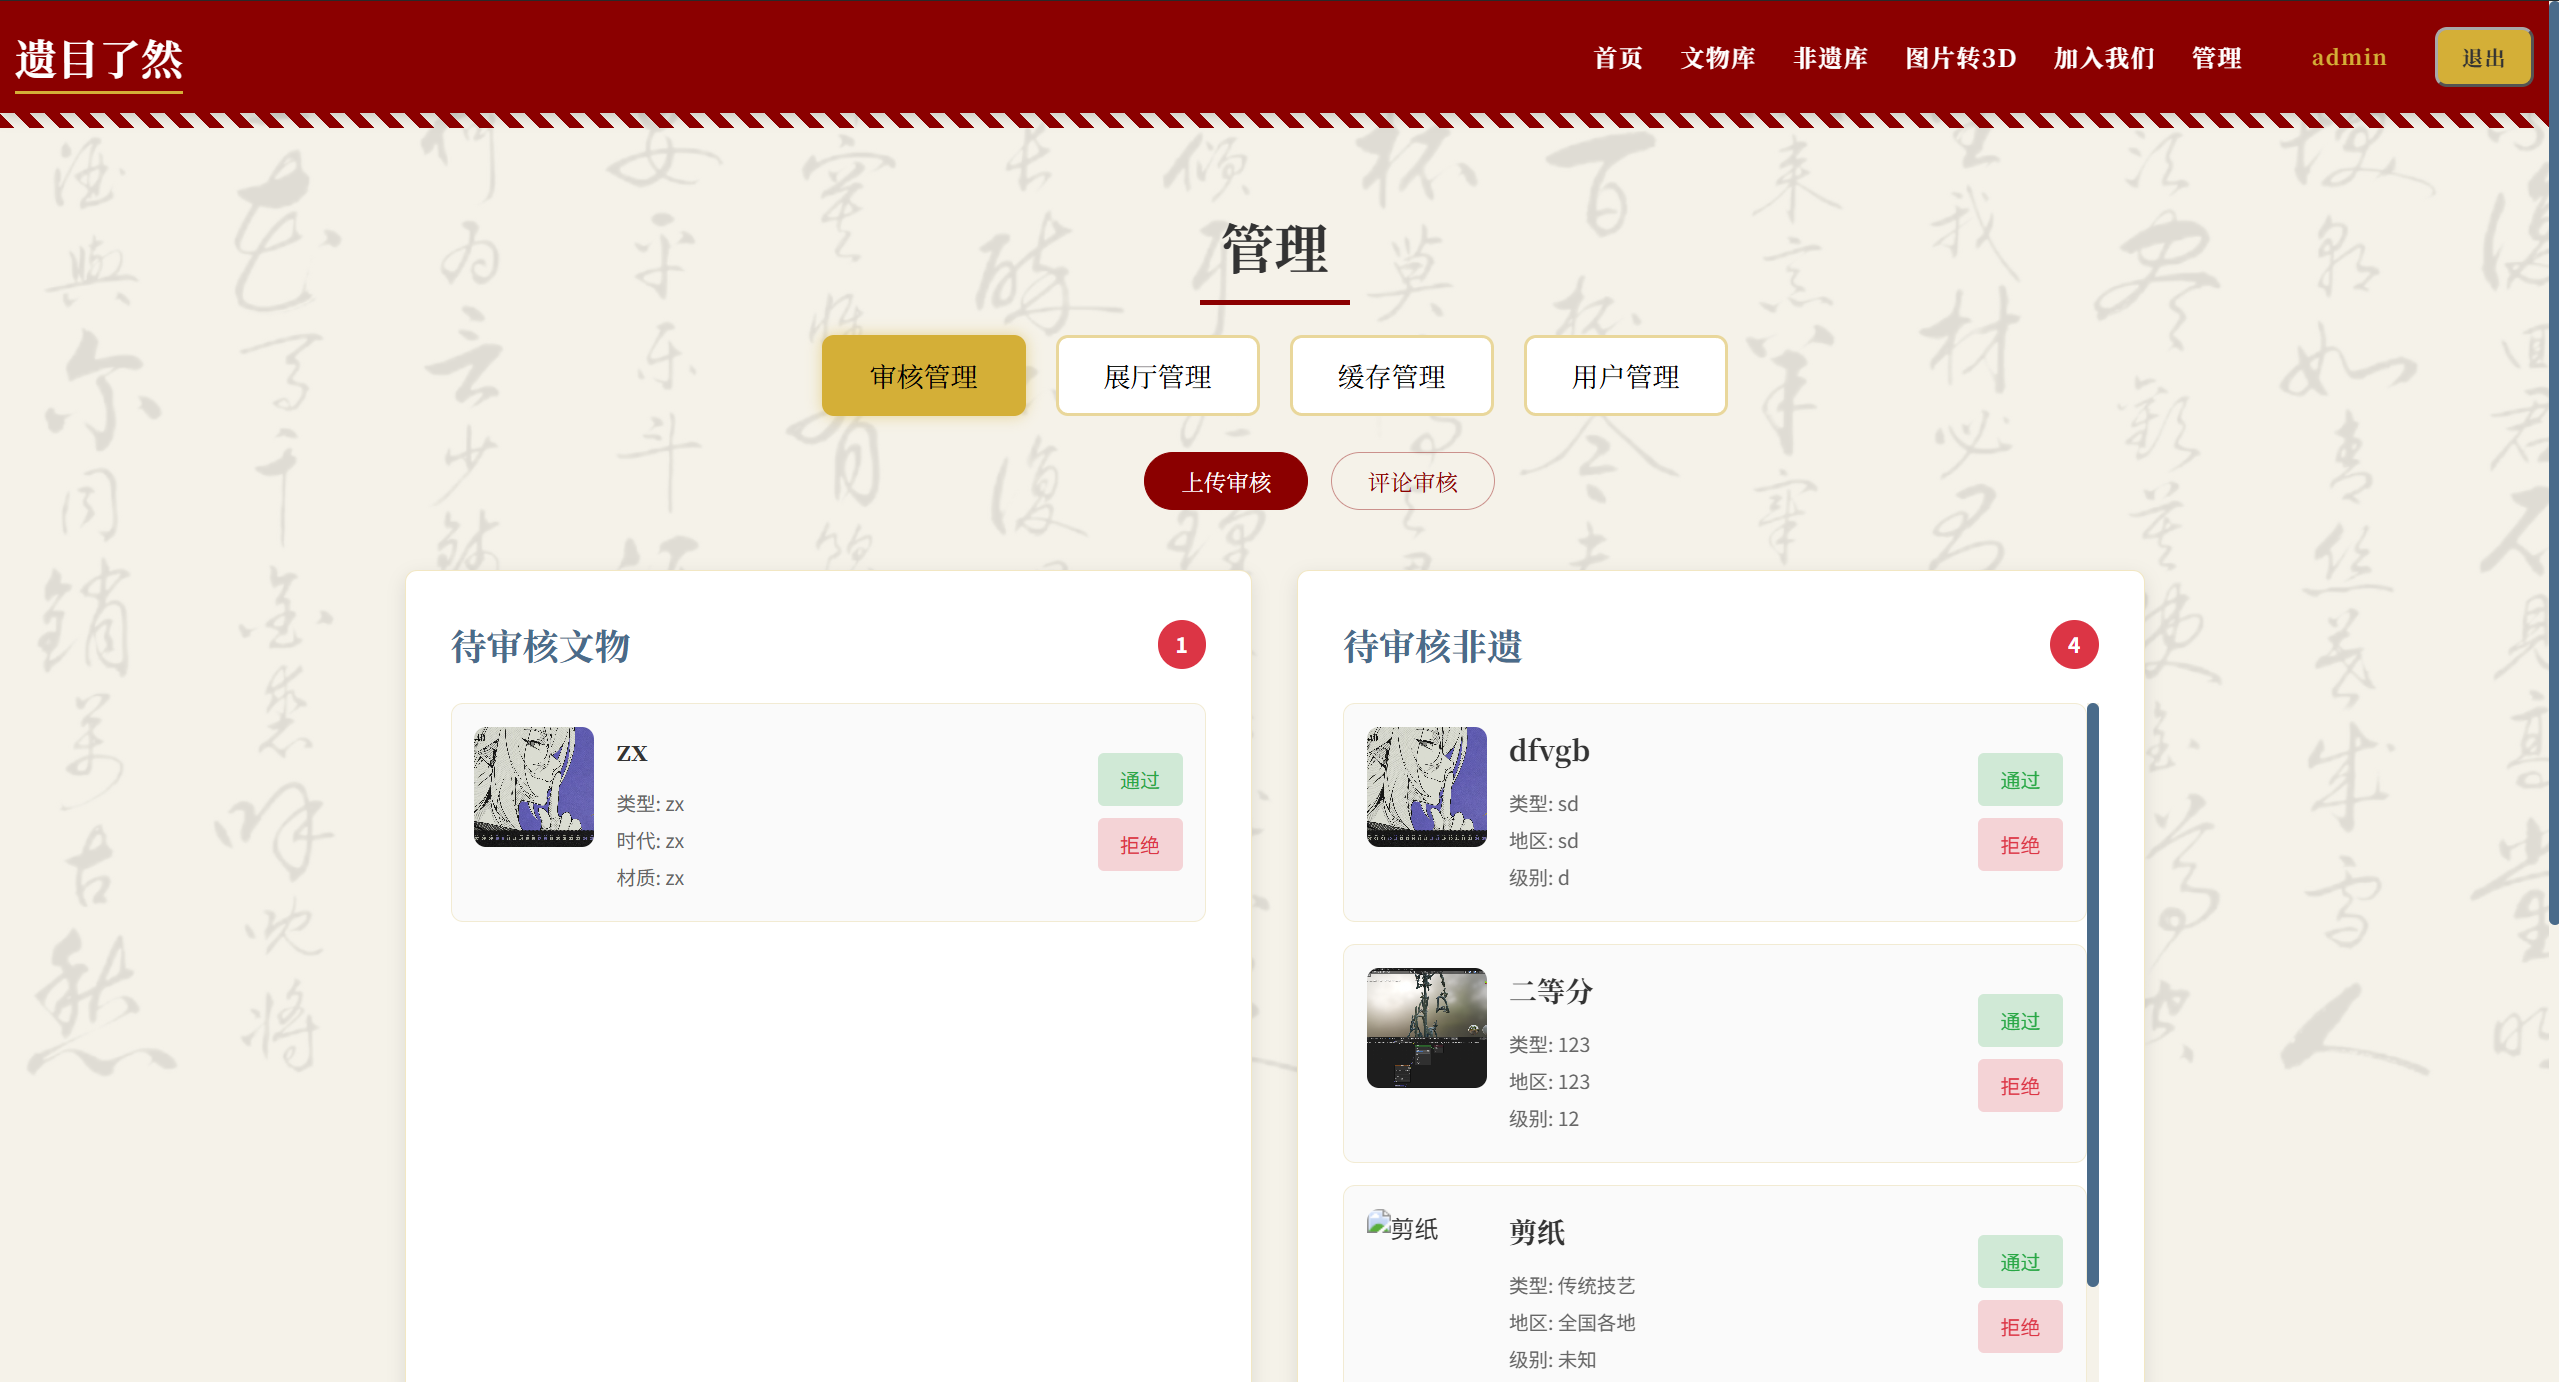
技术架构
前端
前端使用 Vue 3 + Vue Router + Vite 构建单页应用,使用 Axios 与后端接口通信,部分通用组件来自 Element Plus。页面包括首页、文物库、非遗库、详情页、主题展厅、图片转 3D、个人中心和后台管理等。
三维部分使用 Three.js。模型采用 GLB/glTF 格式,通过 GLTFLoader 加载,并接入 DRACOLoader 解析经过 Draco 压缩的模型;OrbitControls 负责相机旋转、缩放和平移。移动端 AR 则使用 <model-viewer>,配合二维码实现桌面端到手机端的跳转。
后端
后端基于 Java 17 + Spring Boot 3,整体按照 Controller、Service、Mapper/Repository 和 Entity 分层。Spring Web 提供 RESTful API,Spring Data JPA 与自定义 Mapper 负责数据访问,Spring Validation 处理参数校验。
数据与缓存
业务数据存储在 MySQL,主要包括用户、文物、非遗、评论、点赞、收藏、展览、展品、上传文件和 AI 生成任务等实体。
高频读取的数据使用 Redis 缓存。
根据变化频率分别配置:热门内容为 5 分钟,列表和详情为 15 分钟,评论为 3 分钟。
新增、修改、审核或删除内容后,Service 会主动清理相应缓存,避免用户长时间看到旧数据。如果启动时 Redis 不可用,系统会自动退回本地内存缓存,保证主要功能仍能运行。
关键功能实现
3D 模型加载与性能优化
最开始直接加载高清模型时,首屏需要等待很久,在网络较慢或设备性能较低的情况下尤其明显。后来的处理方式分成了几层:
- 为文物同时保存“快速加载路径”和“高清模型路径”,页面先展示较小的模型,再由用户按需切换高清版本。
- 使用 Draco 解码器读取压缩后的几何数据,减少模型传输体积。
- 开启 Three.js 资源缓存,同一模型再次打开时直接复用已经加载的 glTF 数据,并在加入场景前克隆模型实例。
- 限制渲染器像素比,并在组件卸载时释放几何体、材质、纹理和事件监听,减少高分辨率屏幕上的渲染压力与内存泄漏。
加载过程除了显示真实进度,还会显示随机文物小知识,算是用户体验上的优化?
图片生成 3D 模型(演示)
项目把它设计成异步任务:
1 | 选择并校验图片 |
前后端都会校验图片格式、大小和分辨率,目前支持 JPG、PNG、WEBP,文件不超过约 4.5 MB,宽高限制在 128~5000 像素。轮询连续失败时会自动重试,等待超过 15 分钟则停止自动查询,用户仍可以手动恢复。任务编号、状态和结果还会保存在浏览器本地,即使中途刷新页面,也可以继续查看原来的生成任务。
问题
模型加载慢
最大的问题。缓存、loading 动画只能缓解等待感,GLB天生需要的传输量就大。最后使用了draco对GLB进行压缩,实测绝大部分模型压缩了80%以上,并且视觉上和原始高清模型差别不大,基本上所有模型都能在1到2分钟内加载出来。同时保留了高清模型的切换,满足部分对高清模型有需要的用户
图片转3D的持久化
- 处理时间长且耗时不可控
把图片提交给混元模型,然后混元又根据图片还原模型,这个过程本身时间就是不可控的,测试的时候一般需要十几分钟以上,但在实际场景中,几乎很少有用户愿意等这么长的时间。 - 生成完之后混元返回的也不是直接可用的glb模型,而是一个临时地址。如果让浏览器直接从这个地址加载模型,可能受到跨域限制;即使当前能够访问,链接过期后也无法继续预览。
解法:
- 轮询。混元的api调用之后会立即返回一个jobId,后端根据jobId轮询任务是否完成。
- 先由后端将这个链接的资源归档,再提供给用户预览/下载。
后续开发方向
CDN
GLB还是太吃存储了,服务器的文件传输压力也大,速度也有限制。有条件就把GLB和贴图之类的迁移到对象存储上再通过CDN分发,提高加载速度
更好的AI生成
目前支持的参数较少。希望加入最大面数、模型大小这些生成参数(如果有支持这些参数的模型)。用户层面做并发限制、调用重试之类的功能